Naše webové stránky obsahují odkazy na partnerské weby. Pokud se prokliknete z našich stránek na stránky partnera a tam si zakoupíte jeho služby, obdržíme za zprostředkování provizi (Zjistit více informací). Tato forma spolupráce nijak neovlivňuje objektivnost našich recenzí. Každým nákupem přes proklik z našich stránek podpoříte naši redakci, abychom i do budoucna mohli tvořit kvalitní a užitečný obsah. Děkujeme.
Počítač na lokální AI v roce 2026: jak vybrat hardware pro vlastní jazykové modely
Obsah
Chcete provozovat jazykové modely u sebe – bez předplatného, bez posílání dat do cloudu a klidně i offline? Pak neřešíte procesor ani „TOPS“ na krabici, ale dvě úplně jiné věci: kolik paměti může model využít a jak rychle ji počítač umí číst. V tomhle průvodci vysvětlujeme, jak lokální AI na počítači doopravdy funguje, kolik paměti potřebují populární modely a jak si v praxi vedou zařízení, která dnes koupíte na Alze – od grafické karty za necelých dvacet tisíc po pracovní stanici pro celý tým. U každého najdete ověřená čísla se zdroji a doporučení, pro koho se hodí, u vybraných i krátké video.
Shrnutí v 30 sekundách
- Rozhoduje paměť. Model musí celý ležet v rychlé paměti, ke které má přístup grafika. Ve 4 bitech počítejte zhruba 0,6 GB na miliardu parametrů.
- Rychlost psaní určuje propustnost paměti, rychlost čtení dlouhého promptu výpočetní výkon. Proto Mac píše rychleji než DGX Spark, ale Spark rychleji čte dlouhé dokumenty.
- Nejlepší poměr cena/výkon dnes: Mac Studio M5 Max se 128 GB (rychlé psaní), Ryzen AI Max+ 395 se 128 GB (nejlevnější velká paměť), RTX 5060 Ti 16 GB (nejlevnější rozumný vstup).
- „AI PC“ s NPU není počítač na lokální AI. Ollama ani LM Studio NPU nepoužívají.
Zařízení jsme sami netestovali – čísla přebíráme z uvedených zdrojů a komunitní měření označujeme. Ceny platí k říjnu 2026 a kvůli nedostatku pamětí se letos mění téměř každý měsíc.
Co koupit podle rozpočtu
Pokud nechcete číst celý článek, tady je zkratka. Každé doporučení níže podrobně rozebíráme i s videem.
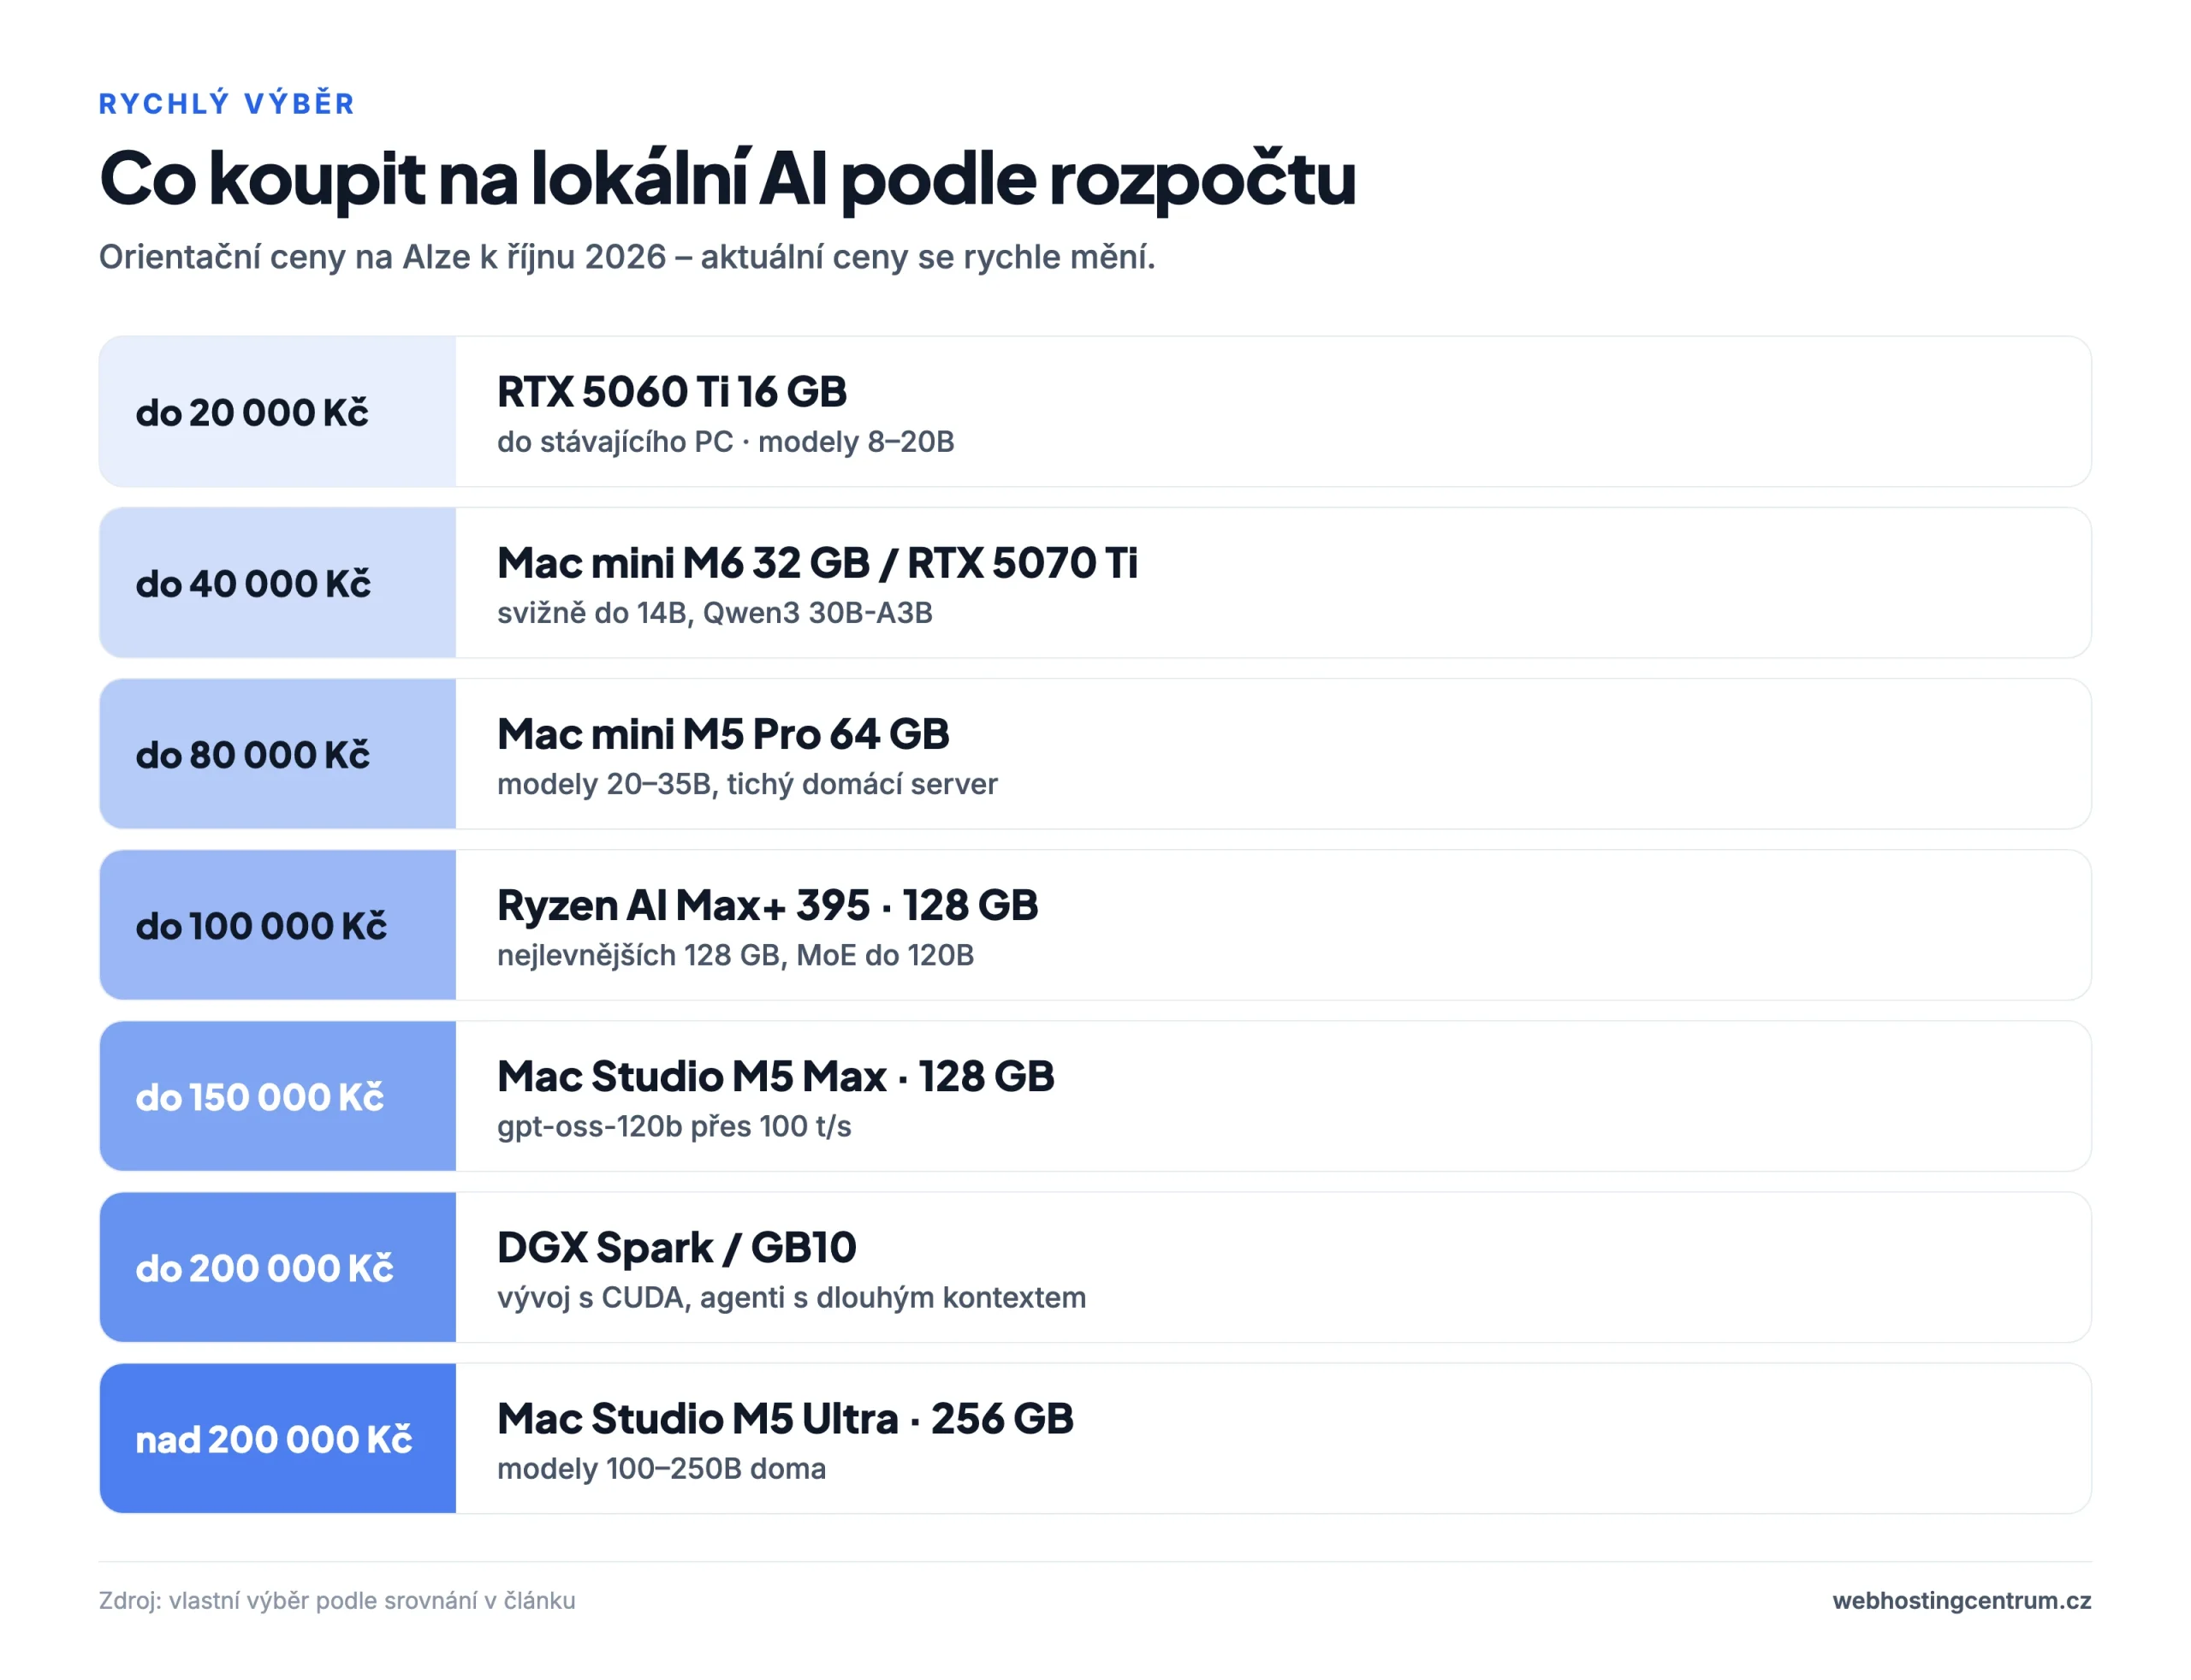
| Rozpočet | Doporučení | Na jaké modely |
|---|---|---|
| do 20 000 Kč | RTX 5060 Ti 16 GB do stávajícího PC | 8–20B (Qwen3 14B, gpt-oss-20b) |
| do 40 000 Kč | Mac mini M6 s 32 GB nebo RTX 5070 Ti | do 14B svižně, Qwen3 30B-A3B |
| do 80 000 Kč | Mac mini M5 Pro s 64 GB | 20–35B, tichý domácí server |
| do 100 000 Kč | Ryzen AI Max+ 395 se 128 GB | velké MoE modely do 120B |
| do 150 000 Kč | Mac Studio M5 Max se 128 GB | gpt-oss-120b přes 100 tokenů/s |
| do 200 000 Kč | DGX Spark nebo jiný GB10 | vývoj s CUDA, programovací agenti |
| nad 200 000 Kč | Mac Studio M5 Ultra s 256 GB | modely 100–250B doma |
| firmy | RTX PRO 6000 v AlzaPC VisionBox PRO | 70–120B pro celý tým |
Proč lokální AI – a co od ní nečekat
Lokální model běží na vašem počítači. Data neopouštějí stůl, neplatíte měsíční předplatné ani poplatky za tokeny, model funguje i bez internetu a nikdo vám ho ze dne na den nezmění. Hodí se proto na práci s citlivými dokumenty, na programovací asistenty nad firemním kódem, na automatizace, které posílají tisíce dotazů denně, nebo prostě pro radost z experimentování.
Má to ale dvě daně. Zaprvé, otevřené modely, které se vejdou do domácího hardwaru, jsou chytré, ale ne na úrovni nejlepších cloudových služeb. Zadruhé, hardware není levný – a jeho cena se v roce 2026 kvůli nedostatku pamětí zvyšuje. Hlavním důvodem pro lokální AI je proto soukromí, kontrola a nezávislost, ne úspora.
Jak model na počítači běží
Když modelu pošlete otázku, proběhnou dvě fáze, a každou brzdí něco jiného:
- Čtení promptu (prefill). Model zpracuje celý váš vstup najednou – otázku, vložený dokument, kód projektu. Tady rozhoduje výpočetní výkon grafiky. Určuje, jak dlouho čekáte na první slovo odpovědi. U krátkého dotazu je to zlomek sekundy, u dokumentu o desítkách tisíc slov i minuty.
- Psaní odpovědi (decode). Model generuje text slovo po slovu (přesněji token po tokenu). Pro každý token musí z paměti přečíst celý model – u modelů typu mixture of experts jen jeho aktivní část. Tady rozhoduje propustnost paměti, tedy kolik gigabajtů za sekundu dokáže čip přečíst.
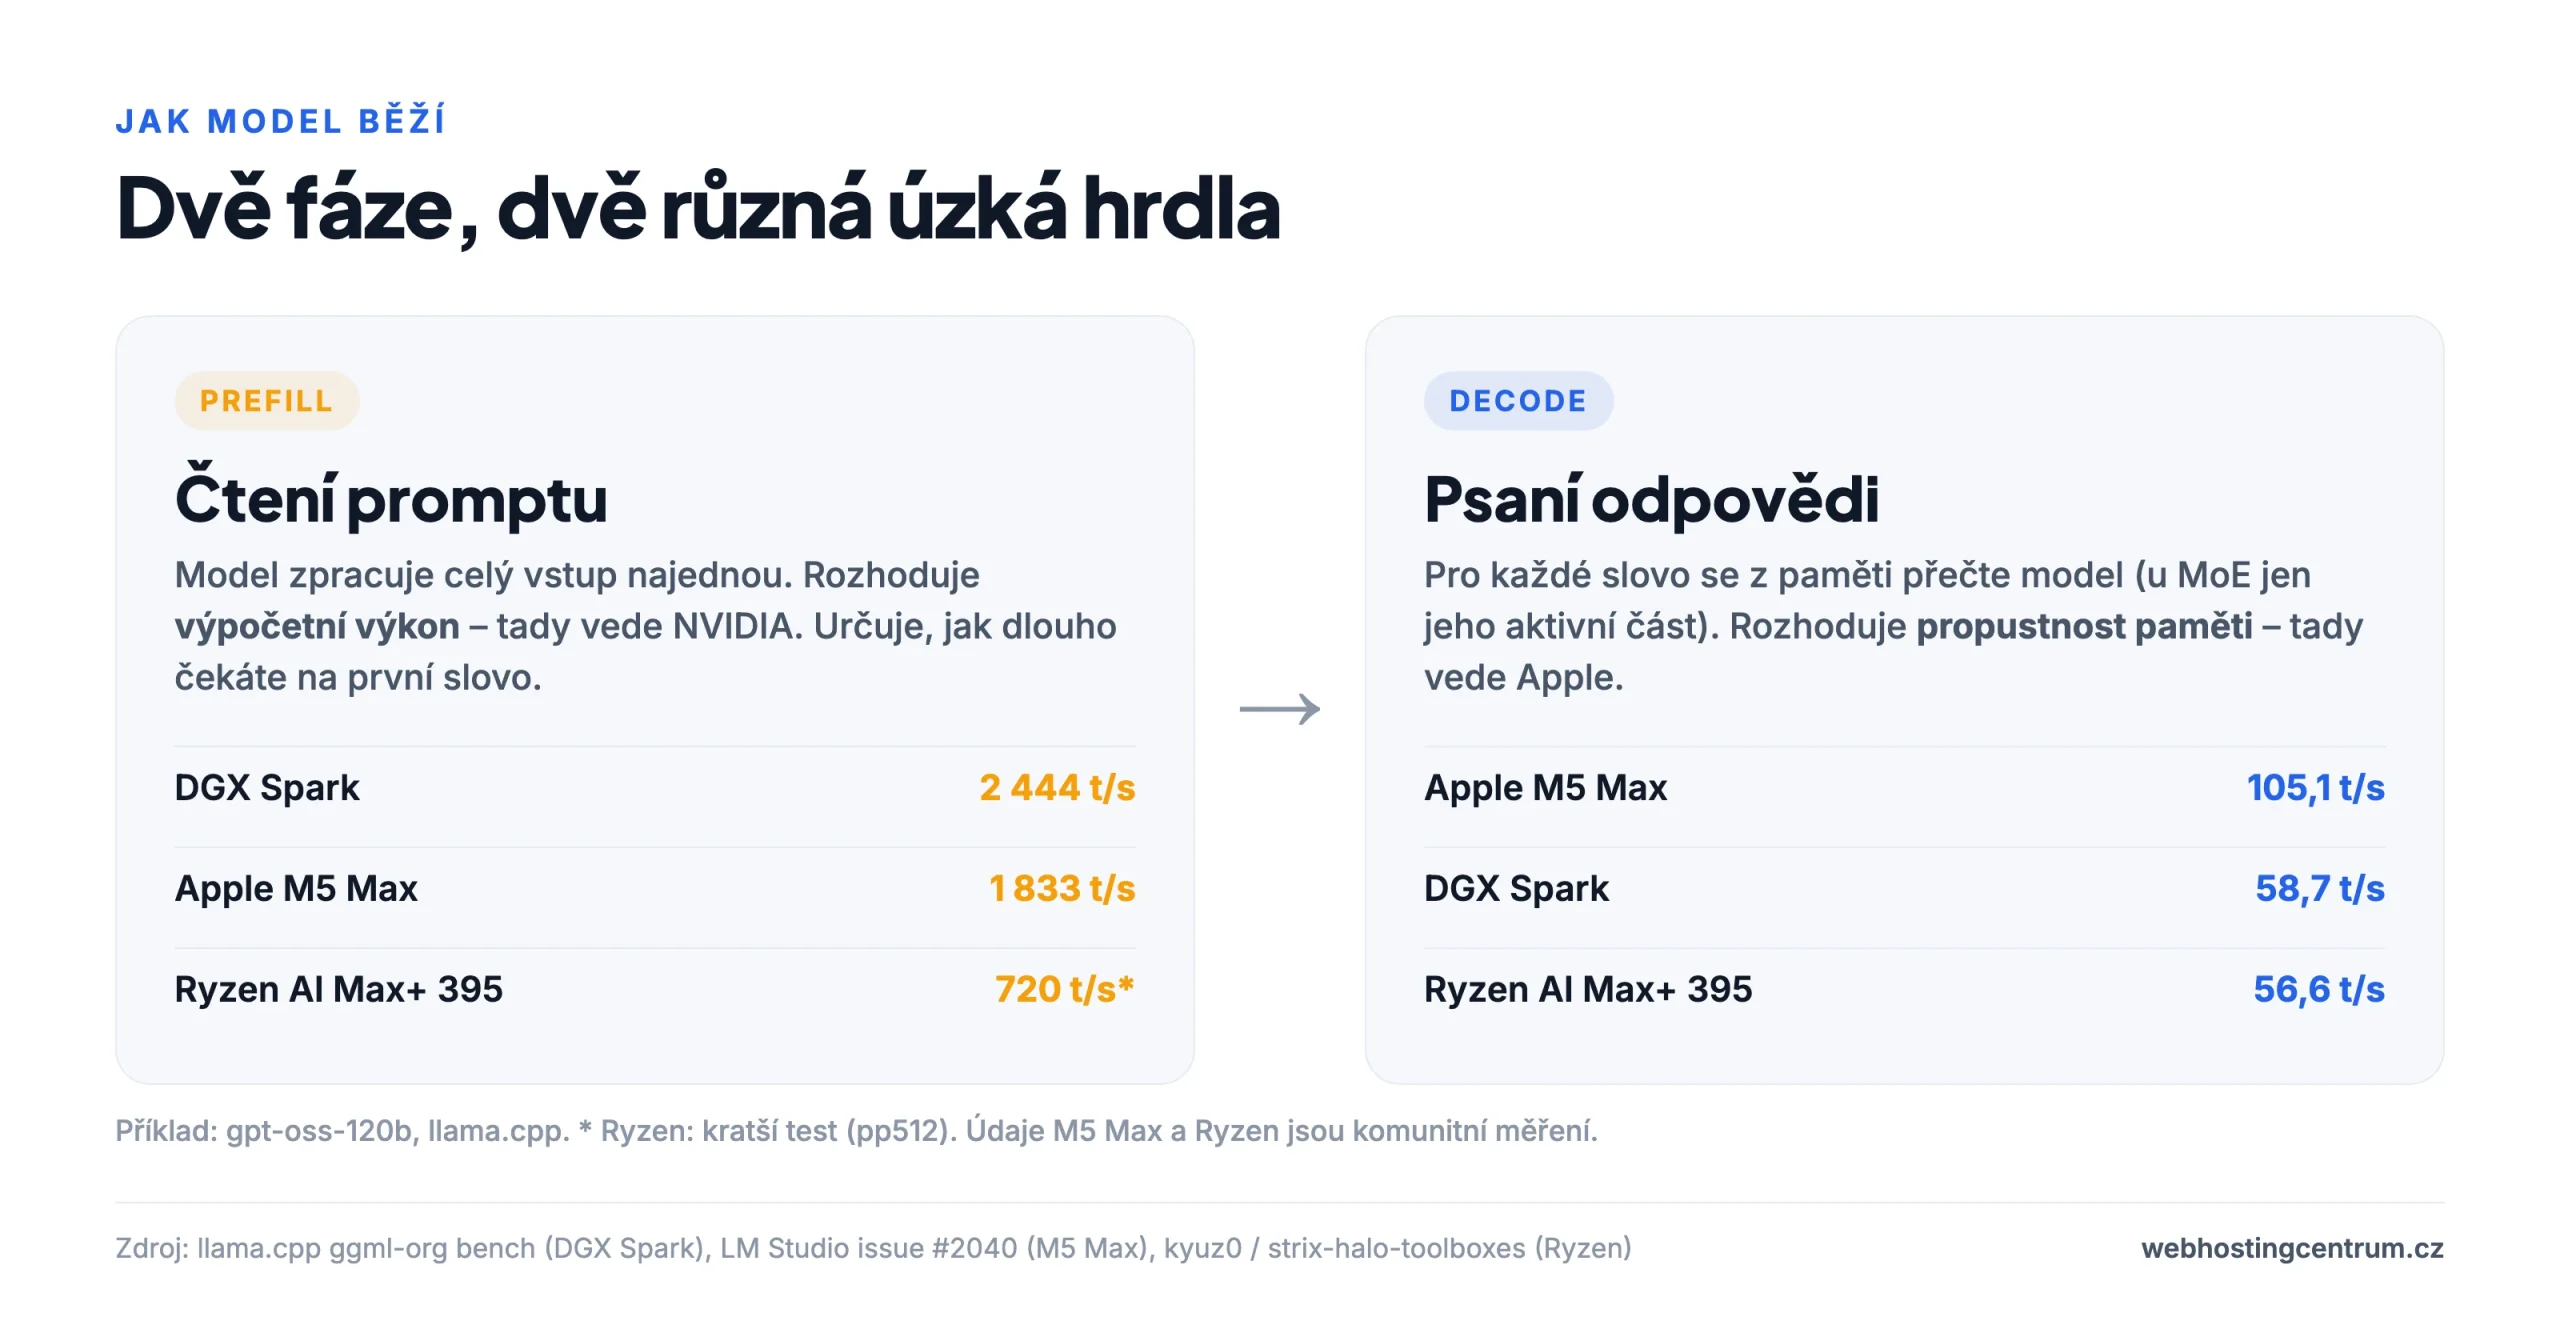
Z toho plyne praktický rozdíl: na chat stačí rychlé psaní (Mac je tu skvělý), na programovací agenty a práci s dokumenty, které modelu neustále posílají obrovský kontext, je důležité i rychlé čtení promptu (tady vede NVIDIA). Rychlost se měří v tokenech za sekundu – jeden token je zhruba tři čtvrtiny slova. Kolem 15 tokenů za sekundu odpovídá rychlosti čtení, nad 50 působí model svižně.
Kolik paměti potřebujete
Model musí celý ležet v rychlé paměti, ke které má přístup grafika: buď ve VRAM grafické karty, nebo ve sdílené (unified) paměti, jakou mají Macy, DGX Spark nebo Ryzen AI Max. Když se nevejde, část putuje do běžné RAM a rychlost se zhroutí. V jednom měření na RTX 5060 Ti stačilo přesunout šestinu vrstev modelu Qwen 14B mimo grafiku a rychlost psaní spadla ze 43 na 12,5 tokenu za sekundu; bez grafiky, jen na procesoru, to bylo 2,9.
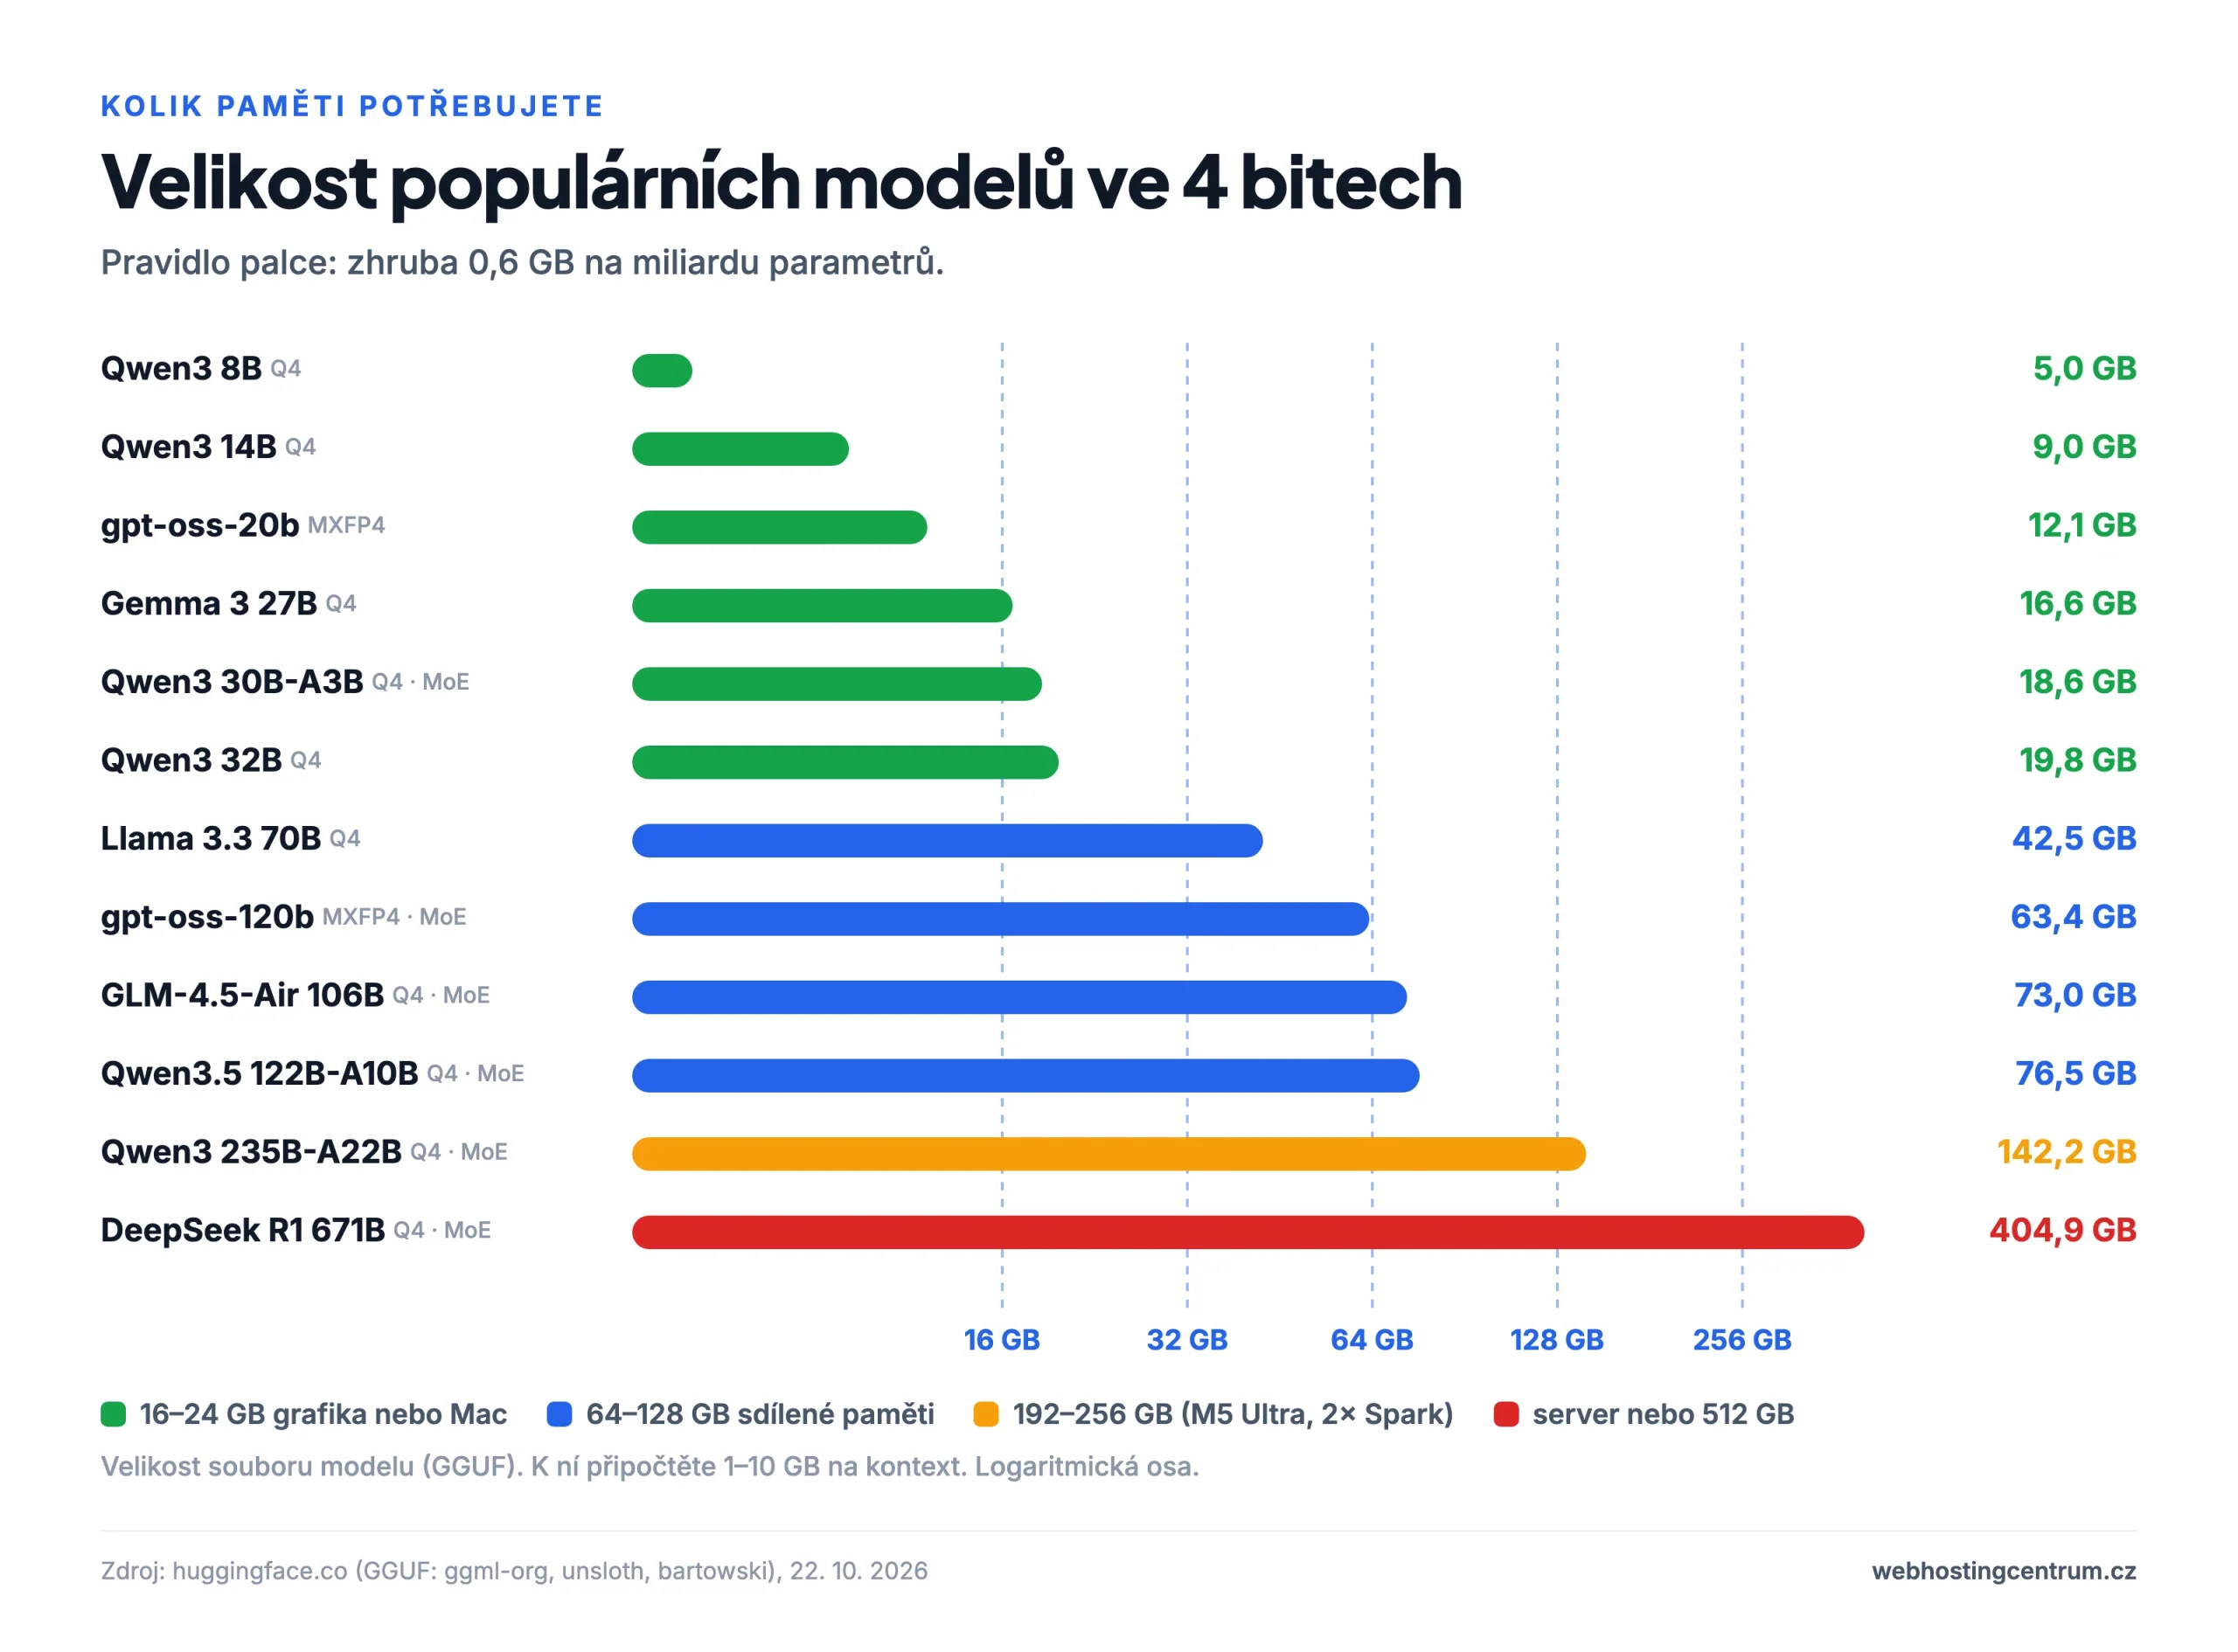
| Model | Typ | Velikost (4 bity) | Kam se vejde |
|---|---|---|---|
| Llama 3.1 8B / Qwen3 8B | hustý | 4,9–5,0 GB | cokoliv s 8 GB |
| Qwen3 14B | hustý | 9,0 GB | 12–16 GB |
| gpt-oss-20b | MoE | 12,1 GB (MXFP4) | 16 GB |
| Gemma 3 27B | hustý | 16,6 GB | 24 GB |
| Qwen3 30B-A3B | MoE, 3B aktivních | 18,6 GB | 24 GB |
| Qwen3 32B | hustý | 19,8 GB | 24–32 GB |
| Llama 3.3 70B | hustý | 42,5 GB | 48 GB a víc |
| gpt-oss-120b | MoE | 63,4 GB (MXFP4) | 96–128 GB |
| GLM-4.5-Air 106B | MoE | 73,0 GB | 96 GB a víc |
| Qwen3.5 122B-A10B | MoE | 76,5 GB | 96–128 GB |
| Qwen3 235B-A22B | MoE | 142,2 GB | 192–256 GB |
| DeepSeek R1 671B | MoE | 404,9 GB | 512 GB |
Kontext stojí další paměť
K samotnému modelu je potřeba připočítat paměť na kontext (tzv. KV cache) – tedy na všechno, co si model z rozhovoru nebo dokumentu „pamatuje“. U Llama 3.3 70B je to při kontextu 32 000 tokenů asi 10 GB navíc, při 128 000 tokenech kolem 40 GB. Modely gpt-oss jsou díky klouzavému oknu mnohem úspornější: gpt-oss-120b potřebuje i pro 128 000 tokenů nejvýš kolem 9 GB. Rychlost psaní se s délkou kontextu také snižuje – gpt-oss-120b na M5 Max píše při krátkém kontextu kolem 80 tokenů za sekundu, při 128 000 tokenech jen 14.
Ne všechna paměť patří grafice
- macOS dovolí grafice ve výchozím stavu zhruba 75 % RAM (Apple přesné číslo neuvádí). Mac se 64 GB tedy pro model nabídne asi 48 GB, se 128 GB asi 96 GB. Limit jde zvýšit příkazem
sudo sysctl iogpu.wired_limit_mb=…, po restartu se ale vrátí. - Windows na Ryzenu AI Max dělí paměť v BIOSu napevno – maximum pro grafiku je 96 GB ze 128 GB. V Linuxu to jde až ke 124 GB.
- Notebooky s NVIDIA RTX Spark mají ve Windows výchozí poměr zhruba 50:50, ručně nejvýš 96 GB ze 128 GB. Verze se 32 GB dá grafice jen 16 GB.
- DGX Spark s Linuxem paměť přiděluje dynamicky, model může využít většinu ze 128 GB.
Kvantizace a MoE jednoduše
Kvantizace je komprese modelu: místo 16 bitů na parametr se použijí 8 nebo 4. Ve 4 bitech (označení Q4, Q4_K_M nebo MXFP4) zabere model zhruba čtvrtinu původní velikosti a kvalita klesne jen mírně – pro domácí použití je to rozumný standard. Osm bitů (Q8) je téměř beze ztráty, ale dvakrát větší.
Mixture of experts (MoE) je architektura, kde má model hodně parametrů, ale při každém slově počítá jen malou část z nich. gpt-oss-120b má 117 miliard parametrů, ale v každém kroku jich zapojí jen kolem pěti miliard; Qwen3 30B-A3B jen tři. Takový model potřebuje velkou paměť, ale píše rychlostí mnohem menšího modelu. Proto jsou MoE modely ideální pro zařízení s velkou, ale pomalejší sdílenou pamětí – DGX Spark, Ryzen AI Max nebo Macy. Husté modely (Llama 70B, Qwen3 32B) naopak čtou při každém slově celý model a na pomalé paměti se táhnou.
Propustnost paměti: proč Mac píše rychleji než Spark
Rychlost psaní se dá docela dobře odhadnout: propustnost paměti vydělená tím, kolik dat musí model přečíst na jeden token. Hustý 70B model ve 4 bitech (~42 GB) proto na DGX Sparku s 273 GB/s nemůže psát rychleji než asi 6–7 tokenů za sekundu – a měření ukazují kolem 4,4.
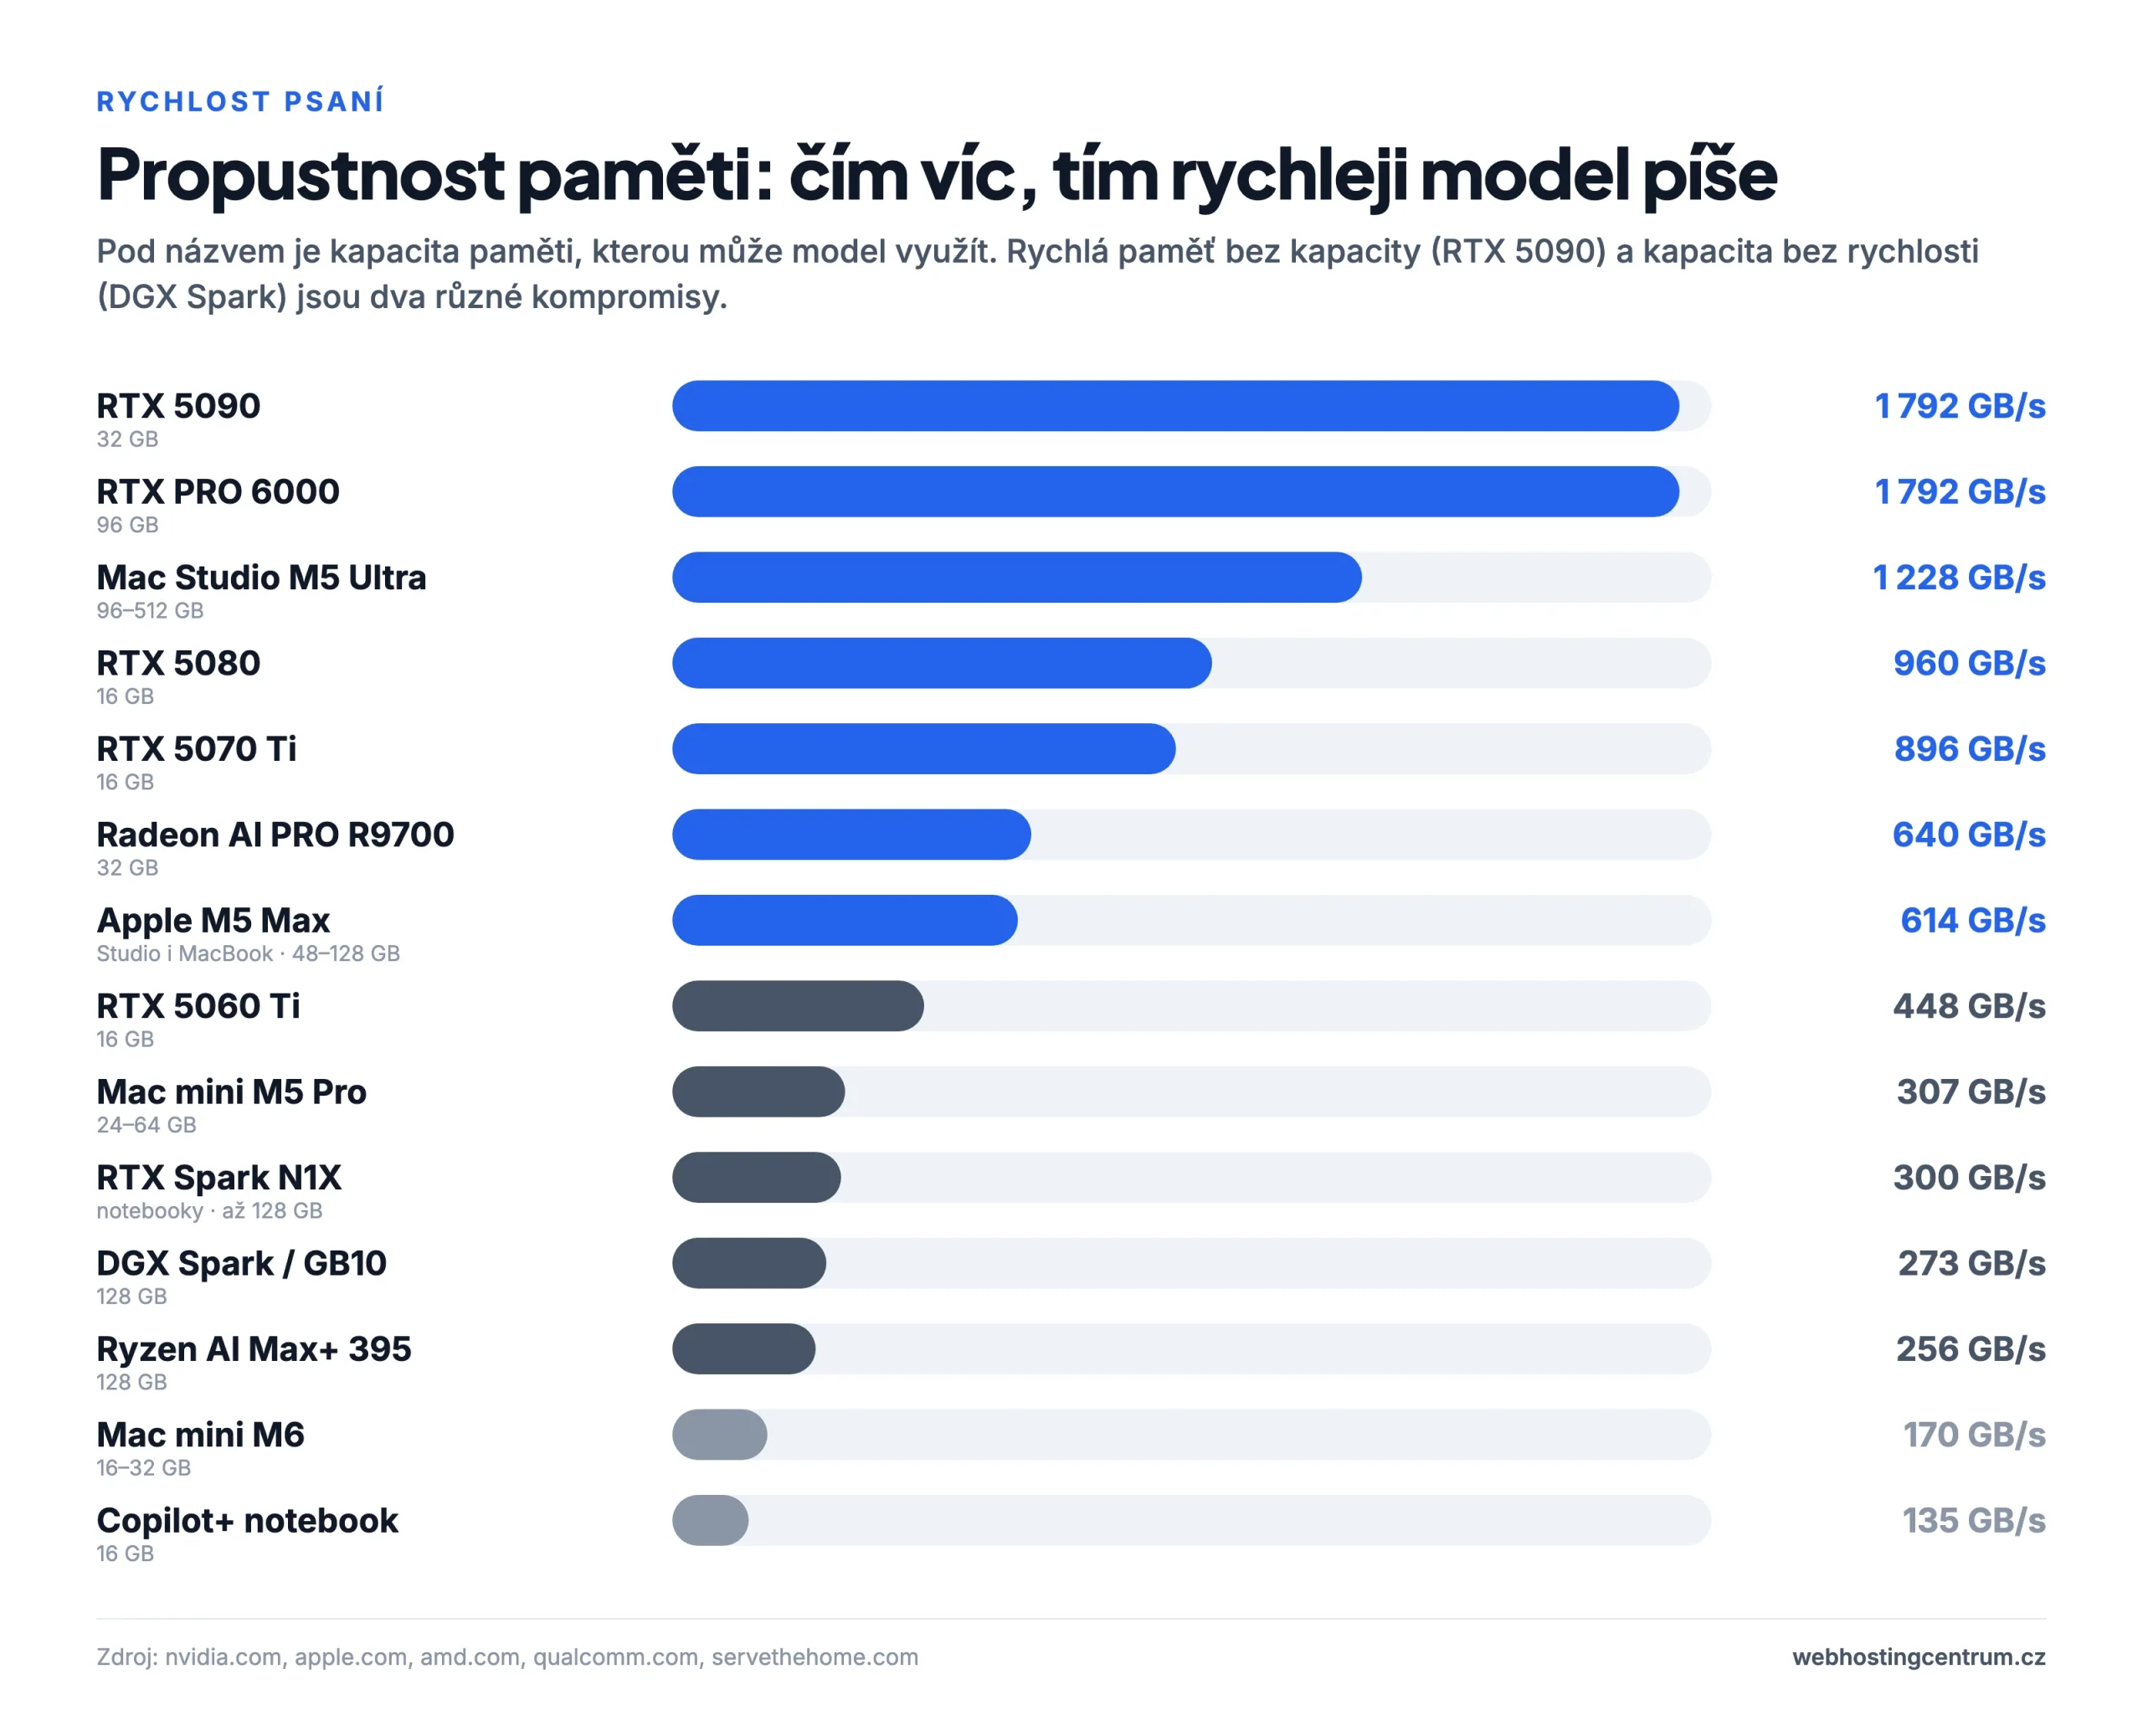
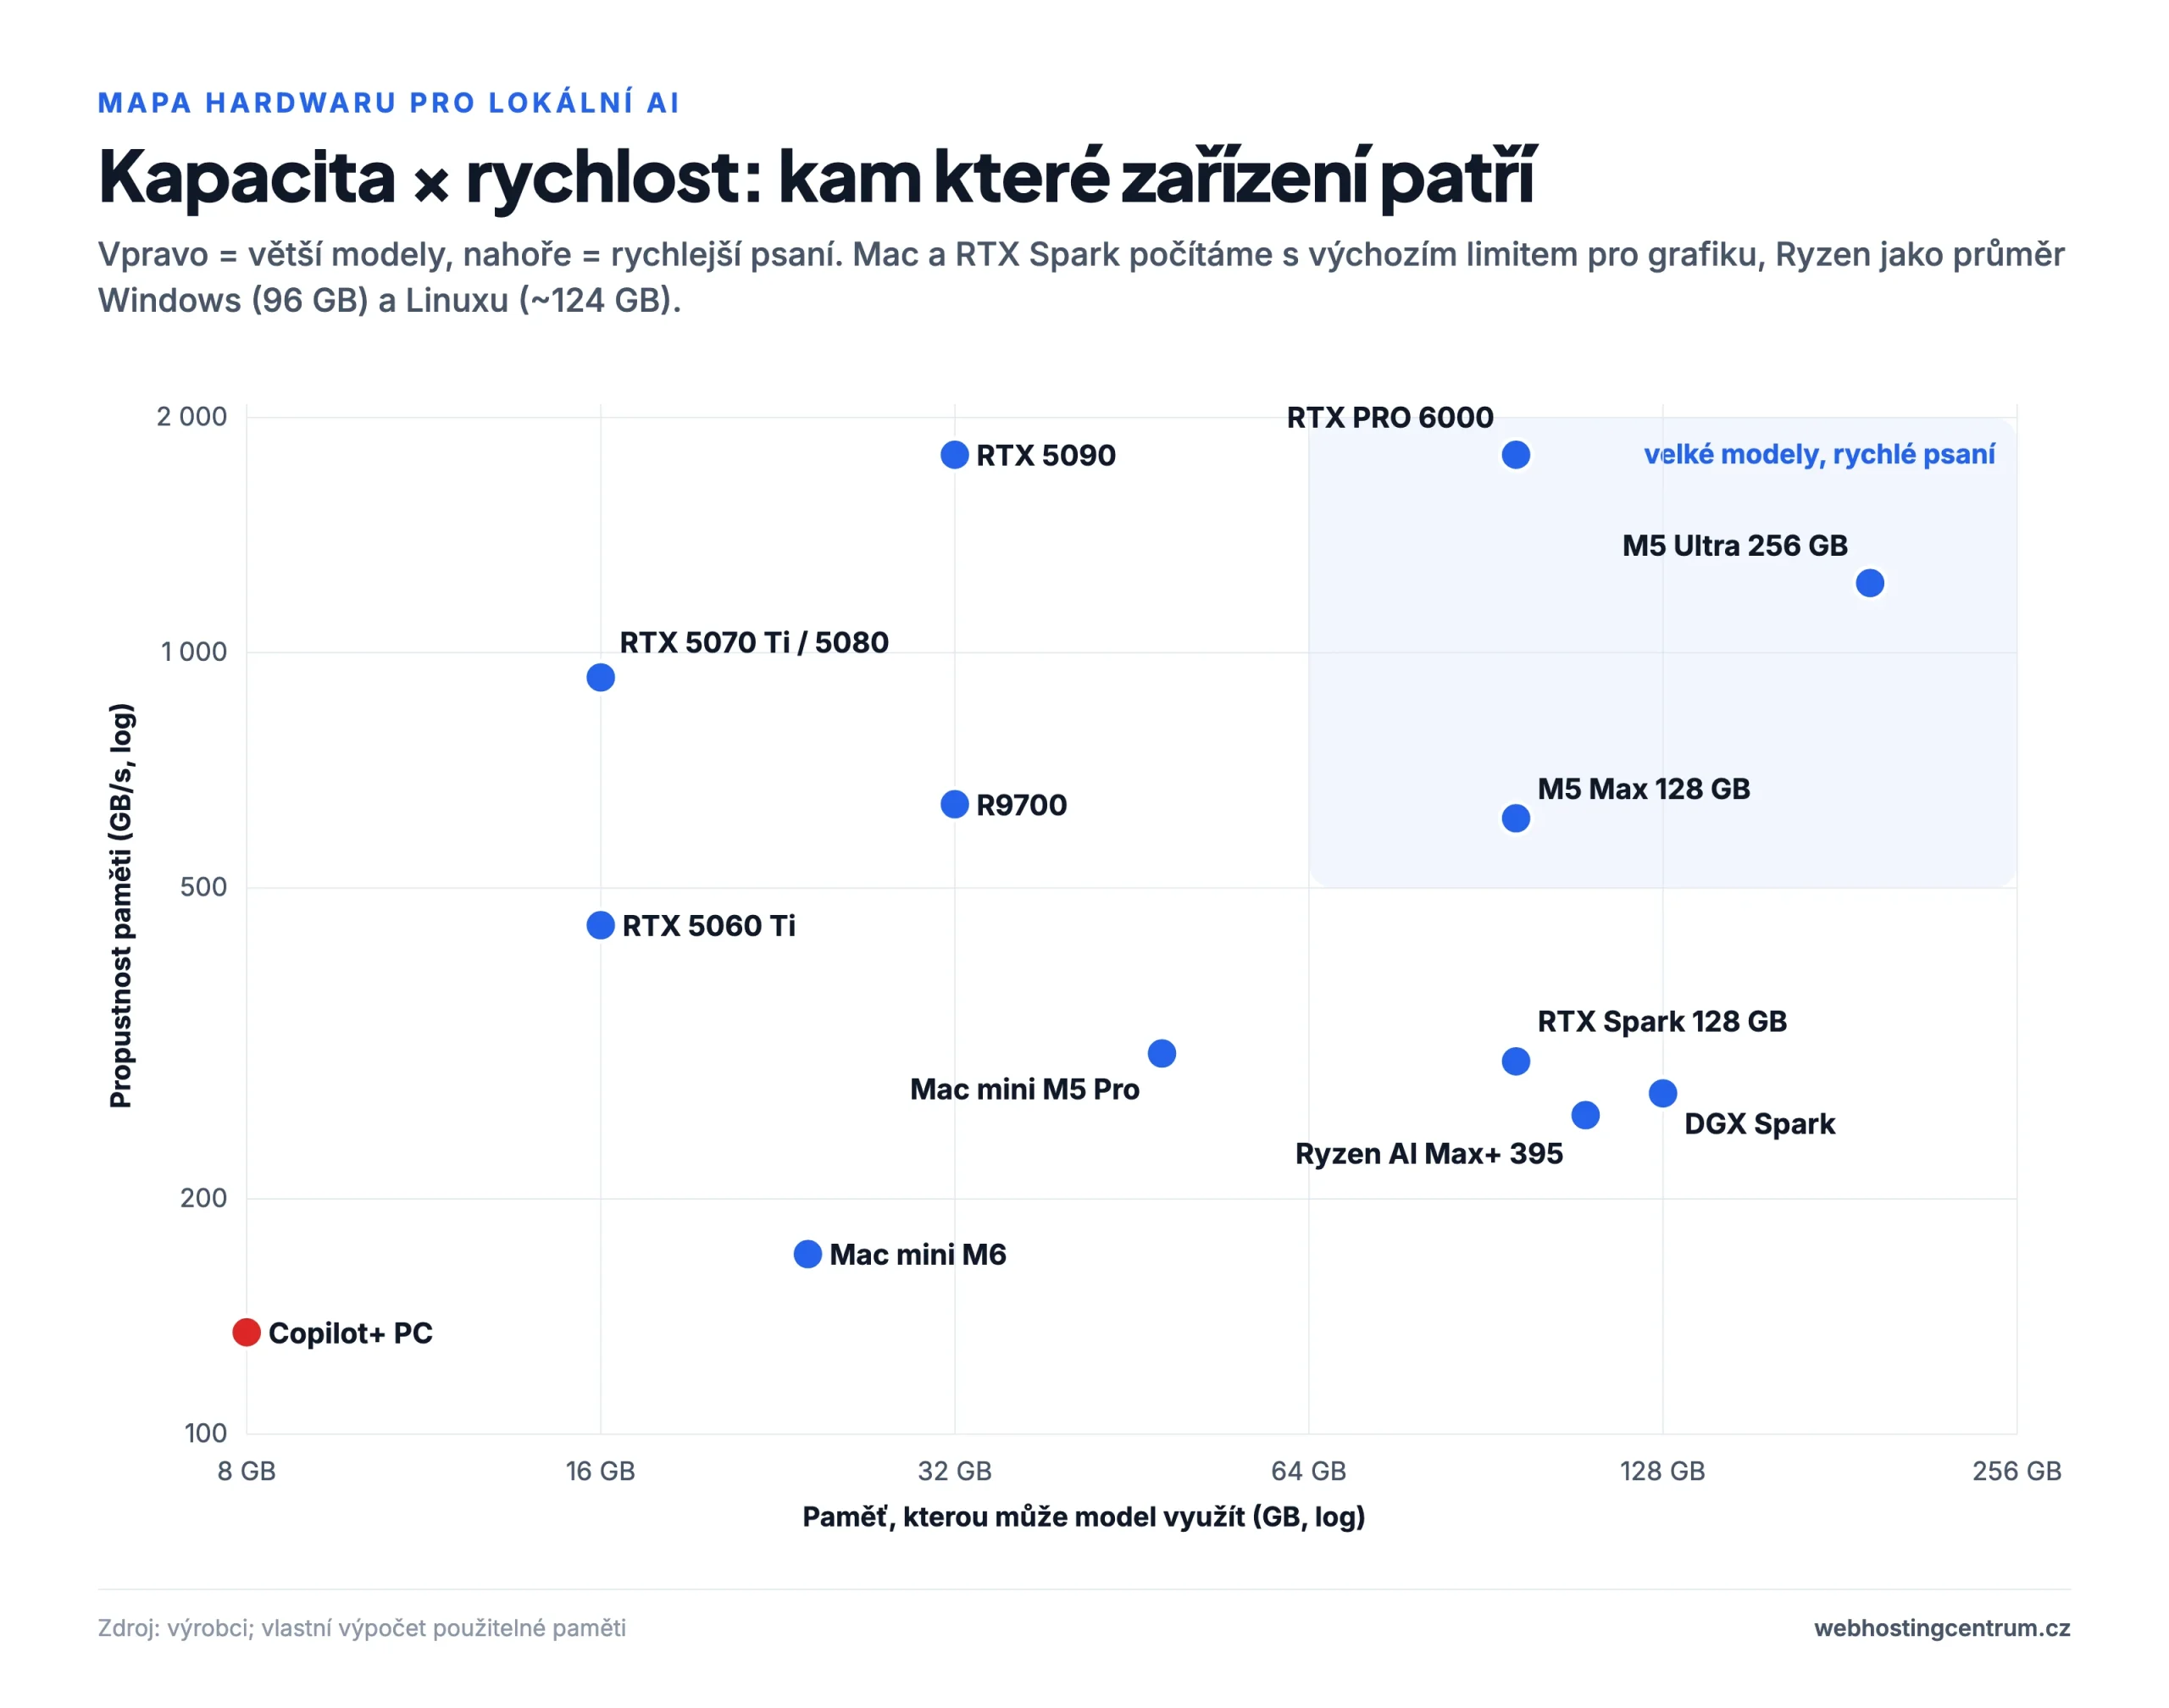
Z mapy je vidět, že dokonalé zařízení neexistuje. Grafické karty NVIDIA mají nejrychlejší paměť, ale málo kapacity. DGX Spark, Ryzen AI Max a RTX Spark mají velkou kapacitu, ale pomalejší paměť. Mac Studio s M5 Max a hlavně M5 Ultra kombinují obojí – za cenu chybějící CUDA a pomalejšího čtení promptu než u NVIDIE.
Stejný model, různý hardware
Nejférovější srovnání je na stejném modelu ve stejném programu. Vybrali jsme gpt-oss-120b od OpenAI (63 GB) a měření z llama.cpp, nejrozšířenějšího programu na lokální modely.
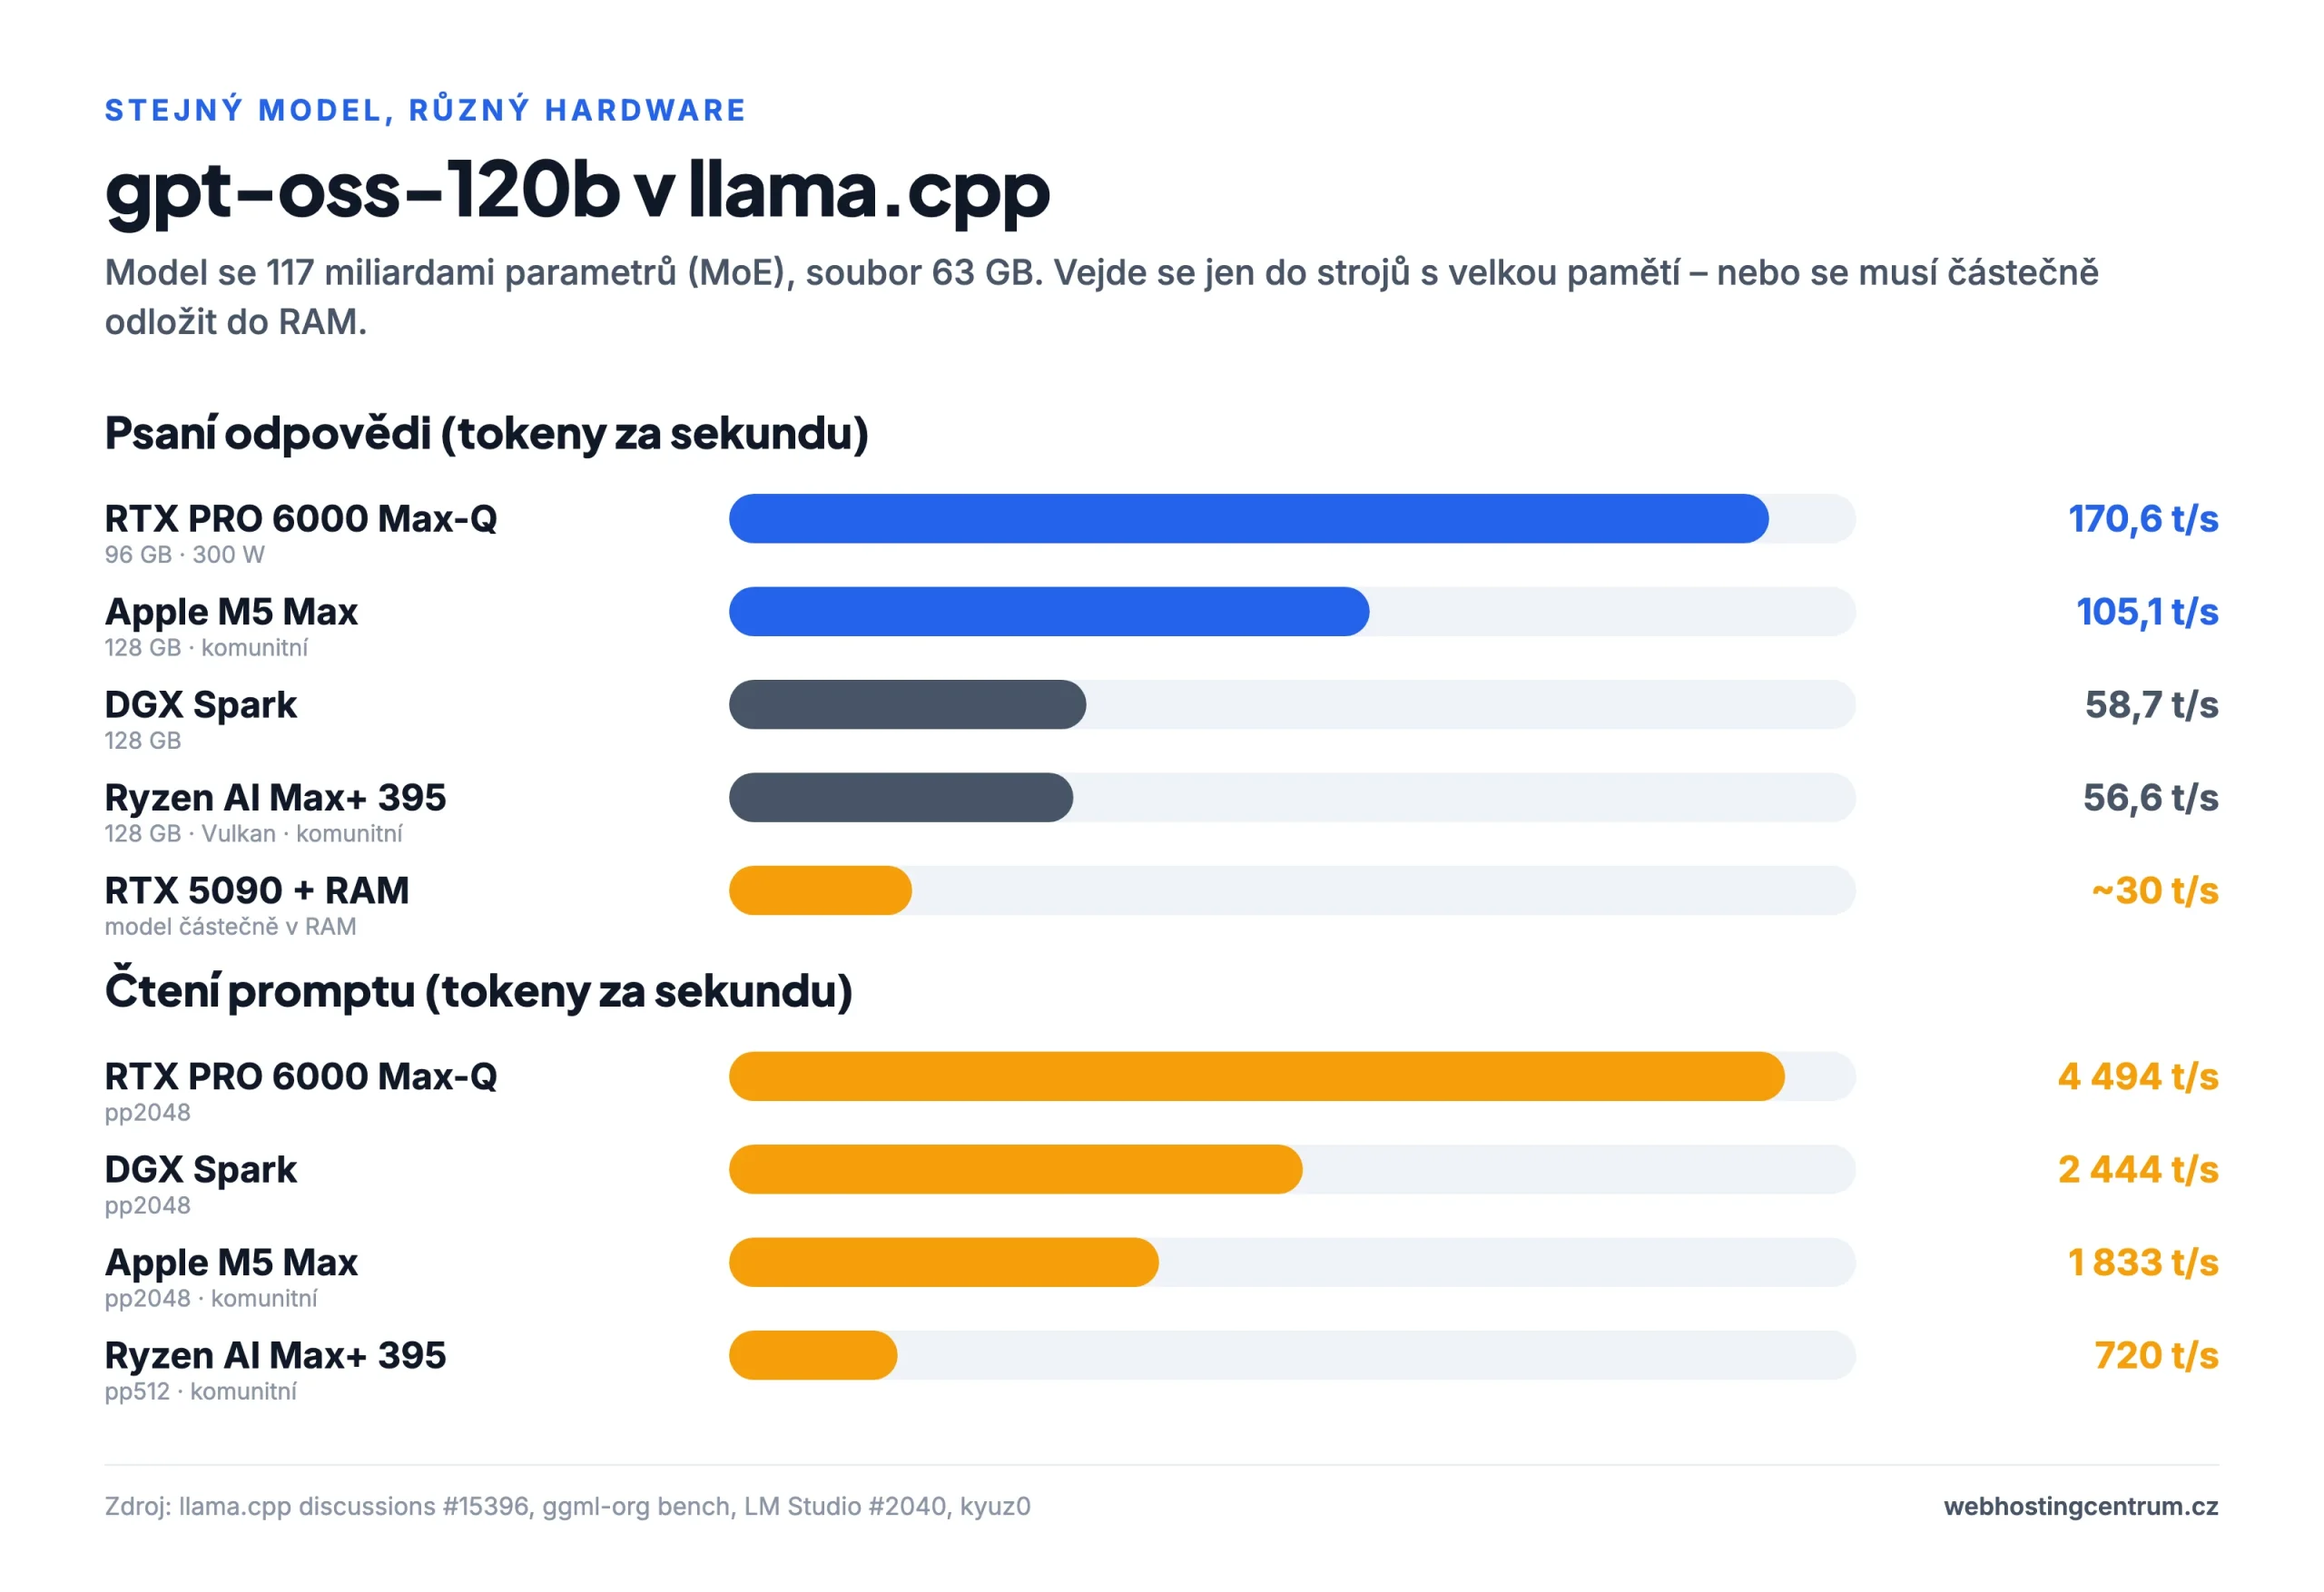
Srovnání všech zařízení
| Zařízení | Paměť pro AI | Propustnost | gpt-oss-120b, psaní | Alza, tato paměť |
|---|---|---|---|---|
| Mac Studio M5 Max | ~96 GB ze 128 GB | 614 GB/s | 105 t/s¹ | 147 990 Kč |
| NVIDIA DGX Spark | 128 GB | 273 GB/s | 58,7 t/s | 189 990 Kč |
| Notebooky RTX Spark | max. 96 GB ze 128 GB | až 300 GB/s | – | 124 989 Kč |
| Ryzen AI Max+ 395 | 96 GB (Win) / ~124 GB (Linux) | 256 GB/s | 56,6 t/s | 99 990 Kč |
| Mac Studio M5 Ultra | ~192 GB z 256 GB | 1 228 GB/s | – | 274 990 Kč |
| Mac mini M5 Pro | ~48 GB ze 64 GB | 307 GB/s | nevejde se | 77 990 Kč |
| Mac mini M6 | ~24 GB z 32 GB | 170 GB/s | nevejde se | 37 990 Kč |
| MacBook Pro M5 Max | ~96 GB ze 128 GB | 614 GB/s | 105 t/s¹ | 194 990 Kč |
| RTX 5090 | 32 GB | 1 792 GB/s | ~30 t/s² | 113 390 Kč |
| RTX 5060 Ti 16 GB | 16 GB | 448 GB/s | nevejde se | 18 199 Kč |
| RTX 5070 Ti / 5080 | 16 GB | 896 / 960 GB/s | nevejde se | 29 999 Kč |
| RTX PRO 6000 Max-Q | 96 GB | 1 792 GB/s | 170,6 t/s | 642 900 Kč |
| GB10 od ASUS, MSI, Lenova… | 128 GB | 273 GB/s | ~ jako Spark | 169 990 Kč |
| Radeon AI PRO R9700 | 32 GB | ~640 GB/s | nevejde se | 52 990 Kč |
| Copilot+ notebooky | ~8 GB z 16 GB | ~135 GB/s | nevejde se | 25 166 Kč |
¹ Komunitní měření na MacBooku Pro M5 Max se 128 GB, llama.cpp. ² Část modelu odložená do systémové RAM. Ceny jsou za konfiguraci s uvedenou pamětí (u karet za samotnou kartu), stav k 22. 10. 2026.
1. Mac Studio M5 Max – nejrychlejší psaní za své peníze
Mac Studio s čipem M5 Max je dnes nejrozumnější volba pro toho, kdo chce co nejrychlejší lokální chat nebo agenta a nepotřebuje CUDA. Paměť s propustností 614 GB/s dává ve verzi se 128 GB modelu gpt-oss-120b rychlost přes 100 tokenů za sekundu – skoro dvakrát víc než DGX Spark. Nové neurální akcelerátory v každém grafickém jádře zrychlily i čtení promptu, ale jen v aktuálním softwaru (viz nastavení softwaru).
- Paměť: 36, 48, 64 nebo 128 GB · propustnost 460 GB/s (36 GB) / 614 GB/s
- Spotřeba: 7 W v klidu, max. 200 W
- Porty: 4× Thunderbolt 5, 10GbE
- Pozor: verze se 36 GB má slabší 32jádrovou grafiku a pro model zbude jen kolem 27 GB. Od 48 GB dostanete plný čip.
Pro koho: chat a agenti s MoE modely, tichý domácí AI server, kdo dělá i video. Pro koho ne: kdo potřebuje CUDA, vLLM nebo trénink.
Na Alze: 64 GB za 99 990 Kč, 128 GB za 147 990 Kč.
2. NVIDIA DGX Spark – stanice pro vývojáře, ne na chat
Čip GB10 se 128 GB sdílené paměti a kompletním softwarem NVIDIA (CUDA, vLLM, TensorRT-LLM) v krabičce 15 × 15 cm. Prompt čte nejrychleji z malých strojů – gpt-oss-120b 2 444 tokenů za sekundu – ale s propustností 273 GB/s píše pomaleji než Mac: 58,7 tokenu za sekundu, hustá Llama 70B jen 4,4. Při běhu modelu bere 60–90 W a dva kusy jdou propojit kabelem QSFP pro modely až kolem 400 miliard parametrů.
- Paměť: 128 GB LPDDR5x · propustnost 273 GB/s
- Grafika: Blackwell, 6 144 jader CUDA · AI výkon 1 PFLOP FP4 (se sparsity, reálně zhruba polovina)
- Systém: DGX OS (Ubuntu na Arm)
- Cena od uvedení vyrostla z 3 999 na zhruba 6 950 dolarů
Pro koho: vývoj s CUDA, programovací agenti s velkým kontextem, fine-tuning do 70B. Pro koho ne: rychlý chat s hustými 70B modely, Windows a hry, začátečníci.
Na Alze: DGX Spark 4 TB za 189 990 Kč, stroje se stejným čipem od 169 990 Kč (srovnání verzí).
3. Notebooky NVIDIA RTX Spark – 128 GB v batohu
Čip N1X je upravený GB10 pro Windows notebooky, s rychlejší pamětí (až 300 GB/s) a příkonem 45–80 W. V testu serveru The Register psal notebook model Qwen3.6 35B-A3B rychlostí 67,6 tokenu za sekundu, tedy rychleji než stolní DGX Spark. Háček je ve Windows: grafika dostane napevno jen část paměti – z 32 GB nejvýš 16 GB, z 64 GB 48 GB, ze 128 GB 96 GB.
- Paměť: 32, 64 nebo 128 GB · propustnost až 300 GB/s
- Grafika: Blackwell, 6 144 jader (výkonem zhruba notebooková RTX 5070)
- Systém: Windows 11 na Arm, CUDA od verze 13.4
- Pozor: první kusy (Surface, HP) v testech při hodinách plné zátěže padaly; Linux oficiálně nepodporován
Pro koho: velké modely v notebooku s Windows, programovací agenti, kreativci. Pro koho ne: verze s 32 GB, dlouhý trénink, software jen pro x86.
Na Alze: 64 GB od 89 989 Kč (Lenovo Yoga Pro 9), 128 GB od 124 989 Kč.
4. Ryzen AI Max+ 395 – nejlevnějších 128 GB
Mini počítače s 16jádrovým Ryzenem a grafikou Radeon 8060S sdílejí 128 GB paměti. Rychlost psaní je srovnatelná s DGX Sparkem (gpt-oss-120b 56,6 tokenu za sekundu) za zhruba poloviční cenu, běží Windows i Linux a zahrajete si. Slabinou je čtení promptu: je dvakrát až třikrát pomalejší než u Sparku a s dlouhým kontextem klesá – v ovladači Vulkan na 146 tokenů za sekundu, v ROCm na 371.
- Paměť: 128 GB LPDDR5x · propustnost 256 GB/s (měřeno ~215)
- Pro grafiku: Windows 96 GB, Linux ~124 GB
- Software: Vulkan nebo ROCm (gfx1151 je od roku 2026 oficiálně podporovaný)
- HP Z2 Mini G1a je dražší, ale je to certifikovaná stanice s pamětí ECC a tříletou zárukou
Pro koho: co nejvíc paměti za korunu, velké MoE modely, chat a souhrny. Pro koho ne: agenti s obřím kontextem, CUDA, tablet ROG Flow Z13 s 32–64 GB na velké modely.
Na Alze: Acer Veriton RA110 a Acemagic A10A za 99 990 Kč, HP Z2 Mini G1a za 145 490 Kč.
5. Mac Studio M5 Ultra – král paměti
Až 512 GB paměti a propustnost 1,2 TB/s. V testu MacStories četl M5 Ultra prompt čtyřikrát rychleji než předchozí M3 Ultra a psal o polovinu rychleji. Do verze s 256 GB se vejde i Qwen3 235B. Přes Thunderbolt 5 a technologii RDMA jde propojit víc kusů: čtyři M5 Ultra podle Applu zvládnou model s 816 miliardami parametrů rychlostí 36,7 tokenu za sekundu.
- Paměť: 96, 256 nebo 512 GB (512 GB přichází koncem října) · propustnost 1 228 GB/s
- Spotřeba: 9 W v klidu, kolem 300 W při běhu modelu
- Porty: 6× Thunderbolt 5
- Pozor: paměť nejde dokoupit; v září byla čekací lhůta až 18 týdnů
Pro koho: modely 100–250B, agenti s dlouhým kontextem, malé týmy. Pro koho ne: modely do 30B, CUDA, omezený rozpočet.
Na Alze: 96 GB od 154 990 Kč, 256 GB od 274 990 Kč.
6. Mac mini M5 Pro – rozumný vstup
Nejlevnější Mac, na kterém už rozjedete opravdu použitelné modely. Propustnost 307 GB/s, až 64 GB paměti a Thunderbolt 5. Díky neurálním akcelerátorům čte prompt zhruba třikrát rychleji než předchozí M4 Pro. Ve verzi se 64 GB poběží modely do 32 miliard parametrů pohodlně, hustá Llama 70B se vejde, ale poběží jen kolem 7 tokenů za sekundu, a gpt-oss-120b se nevejde.
- Paměť: 24, 48 nebo 64 GB · propustnost 307 GB/s
- Spotřeba: 6 W v klidu, max. 145 W · v klidu prakticky neslyšný
Pro koho: modely 20–35B, tichý domácí AI server. Pro koho ne: gpt-oss-120b, husté 70B, verze s 24 GB.
Na Alze: 48 GB za 65 990 Kč, 64 GB za 77 990 Kč.
7. Mac mini M6 – levně, ale ne s 16 GB
Nejlevnější Mac s neurálními akcelerátory. Maximum je 32 GB a propustnost 170 GB/s – šestnáctigigabajtová verze má jen 153 GB/s a pro model zbude kolem 12 GB. Proti předchozímu Macu mini s M4 čte prompt 4,5× rychleji a píše o polovinu rychleji za prakticky stejnou cenu, takže starý model nekupujte ani ve slevě.
- Paměť: 16, 24 nebo 32 GB (maximum) · propustnost 153 / 170 GB/s
- Spotřeba: 4 W v klidu, max. 70 W
- Pozor: jen Thunderbolt 4, takže bez propojování více kusů
Pro koho: modely 7–14B, gpt-oss-20b, Qwen3 30B-A3B. Pro koho ne: verze s 16 GB, modely 70B a víc.
Na Alze: 24 GB za 31 990 Kč, 32 GB za 37 990 Kč.
8. MacBook Pro M5 Max – AI na cestách
Stejný čip jako Mac Studio, a tedy i stejná rychlost: nejrychlejší notebook na lokální modely. Se středně velkým modelem Qwen3.6 35B-A3B generuje přes 90 tokenů za sekundu. Čtrnáctipalcová verze se ale pod trvalou zátěží přiškrcuje (příkon z 96 na 42 W) a nabíjení je omezené na 97 W. Mac Studio se stejným čipem a 128 GB stojí o 47 tisíc méně.
- Paměť: 36, 48, 64 nebo 128 GB · propustnost 460 / 614 GB/s
- Baterie: 72,4 Wh (14″) / 100 Wh (16″)
Pro koho: kdo potřebuje velké modely s sebou, ideálně šestnáctipalcový se 64–128 GB. Pro koho ne: verze s 36 GB, trvalý provoz, kdo pracuje u stolu.
Na Alze: 64 GB od 142 490 Kč, 128 GB za 194 990 Kč.
9. RTX 5090 – nejrychlejší, ale jen 32 GB
Propustnost 1 792 GB/s: model gpt-oss-20b píše skoro 300 tokenů za sekundu a dlouhý prompt karta čte zhruba dvakrát rychleji než Mac Studio s M5 Ultra. Do 32 GB se vejdou modely do zhruba 32 miliard parametrů ve 4 bitech i s dlouhým kontextem; sedmdesátimiliardový model ne. Velké MoE modely jde částečně odložit do běžné RAM – gpt-oss-120b pak běží kolem 30 tokenů za sekundu.
- Paměť: 32 GB GDDR7 · propustnost 1 792 GB/s
- Příkon: 575 W, doporučený zdroj 1 000 W
- Cena při uvedení 1 999 dolarů, letos kvůli nedostatku pamětí výrazně výš
Pro koho: programovací agenti a RAG s modely do 32B, vývoj s CUDA, hry. Pro koho ne: modely 70B a víc, tichý úsporný server.
Na Alze: karta od 113 390 Kč (rozbalená), hotové PC s RTX 5090 od zhruba 250 000 Kč.
10. RTX 5060 Ti 16 GB – nejlevnější rozumný vstup
Nejlevnější nová šestnáctigigabajtová grafika na Alze. Model gpt-oss-20b na ní píše kolem 92 tokenů za sekundu, Qwen3 8B 69 a Qwen3 14B 41 – rychleji, než stihnete číst. Propustnost paměti je ale poloviční proti RTX 5070 Ti, takže píše zhruba polovičním tempem, a modely kolem 30 miliard parametrů se do 16 GB nevejdou.
- Paměť: 16 GB GDDR7 · propustnost 448 GB/s
- Příkon: 180 W, stačí zdroj 600 W
Pro koho: první vážné pokusy, modely 8–20B, levné PC na AI. Pro koho ne: modely 27B a víc.
Na Alze: od 18 199 Kč.
11. RTX 5070 Ti vs. RTX 5080 – na AI skoro stejné
Obě karty mají 16 GB a skoro stejnou propustnost (896 vs. 960 GB/s), a proto píšou téměř stejně rychle: ve standardním testu llama.cpp 182,4 vs. 184,7 tokenu za sekundu, u modelu Qwen3 14B 74 vs. 81. Vejdou se do nich přesně stejné modely. Pětaosmdesátka je rychlejší hlavně ve hrách a stojí o 10–14 tisíc víc.
Doporučení: na AI berte RTX 5070 Ti a ušetřené peníze dejte do většího disku nebo RAM. RTX 5080 kupte jen tehdy, když na ní budete hlavně hrát.
Na Alze: RTX 5070 Ti od 29 999 Kč, RTX 5080 od 39 990 Kč.
12. RTX PRO 6000 – 96 GB v jedné kartě
Jediná karta, do které se celá vejde Llama 3.3 70B (32 tokenů za sekundu), gpt-oss-120b (170,6 tokenu za sekundu ve verzi Max-Q) i Qwen3.5 122B (kolem 98 tokenů za sekundu). Díky CUDA a nástroji vLLM zvládne obsloužit víc uživatelů najednou. Alza ji prodává v hotových pracovních stanicích AlzaPC VisionBox PRO s procesorem Threadripper PRO – jako firemní zboží, které nejde vrátit.
- Paměť: 96 GB GDDR7 s ECC · propustnost 1 792 GB/s
- Příkon: 300 W (Max-Q), plná verze 600 W s asi o 13 % rychlejším psaním
Pro koho: firmy a týmy, které chtějí provozovat velké modely interně nebo je trénovat. Pro koho ne: jednotlivci a hobby.
Na Alze: VisionBox PRO s jednou kartou za 642 900 Kč, levnější alternativou jsou dvě karty Radeon AI PRO (64 GB) za 364 900 Kč.
13. DGX Spark od ASUSu, MSI, Lenova, Dellu a Gigabyte – který vybrat
Stejný čip GB10 jako DGX Spark prodává pět dalších výrobců. Výkon v AI se liší jen o pár procent, rozdíl je v disku, zdroji, chlazení a servisu – a v ceně, která se na Alze liší o desítky tisíc.
| Model | Disk | Zdroj | Specialita |
|---|---|---|---|
| NVIDIA / PNY DGX Spark | 4 TB šifrovaný | 240 W | originál |
| GIGABYTE AI TOP ATOM | 4 TB PCIe 5.0 | 240 W | nejrychlejší disk |
| ASUS Ascent GX10 | 1 TB PCIe 4.0 / 4 TB PCIe 5.0 | 240 W | tlačítko vpředu |
| Lenovo ThinkStation PGX | 1 / 2 / 4 TB šifrovaný | 240 W | rok servisu na místě |
| Dell Pro Max s GB10 | PCIe 4.0 (2 TB QLC) | 280 W | silnější zdroj, nejteplejší disk |
| MSI EdgeXpert | 4 TB | – | novinka bez nezávislých testů |
Doporučení: nejlepší výbavu za rozumné peníze má Gigabyte AI TOP ATOM se 4 TB rychlého disku; nejlevnější vyzkoušený start je ASUS Ascent GX10 s 1 TB. Kdo plánuje propojit dva kusy, potřebuje kabel QSFP.
Na Alze: od 169 990 Kč (MSI EdgeXpert), Gigabyte AI TOP ATOM 4 TB za 174 990 Kč.
14. Radeon AI PRO R9700 – 32 GB za polovinu ceny RTX 5090
Nejlevnější nová karta s 32 GB. Ve stejném testu přes Vulkan píše zhruba o 40 % pomaleji než RTX 5090, ale vejdou se do ní stejné modely – kolem 30 miliard parametrů i s delším kontextem. gpt-oss-20b a Qwen3 30B-A3B na ní běží přes 150 tokenů za sekundu. Pozor na marketing: „až pětkrát rychlejší než RTX 5080“ platí jen pro model, který se do 16 GB nevejde.
- Paměť: 32 GB GDDR6 · propustnost ~640 GB/s · příkon 300 W
- Software: Vulkan (obvykle rychleji píše) nebo ROCm (rychleji čte prompt); bez CUDA
Pro koho: modely 27–32B s dlouhým kontextem, víc karet v jednom PC. Pro koho ne: nástroje jen pro CUDA, maximální rychlost.
Na Alze: 52 990 Kč.
15. „AI PC“ a Copilot+ notebooky – mýtus
Copilot+ je certifikace Microsoftu pro funkce Windows – efekty kamery, živé titulky, Recall nebo malý vestavěný model Phi Silica. Neříká nic o schopnosti provozovat velké jazykové modely. Ollama ani LM Studio neurální procesor (NPU) nepoužívají, llama.cpp jen experimentálně; NPU využijí jen nástroje výrobců jako Microsoft Foundry Local nebo AMD Lemonade s vybranými modely.
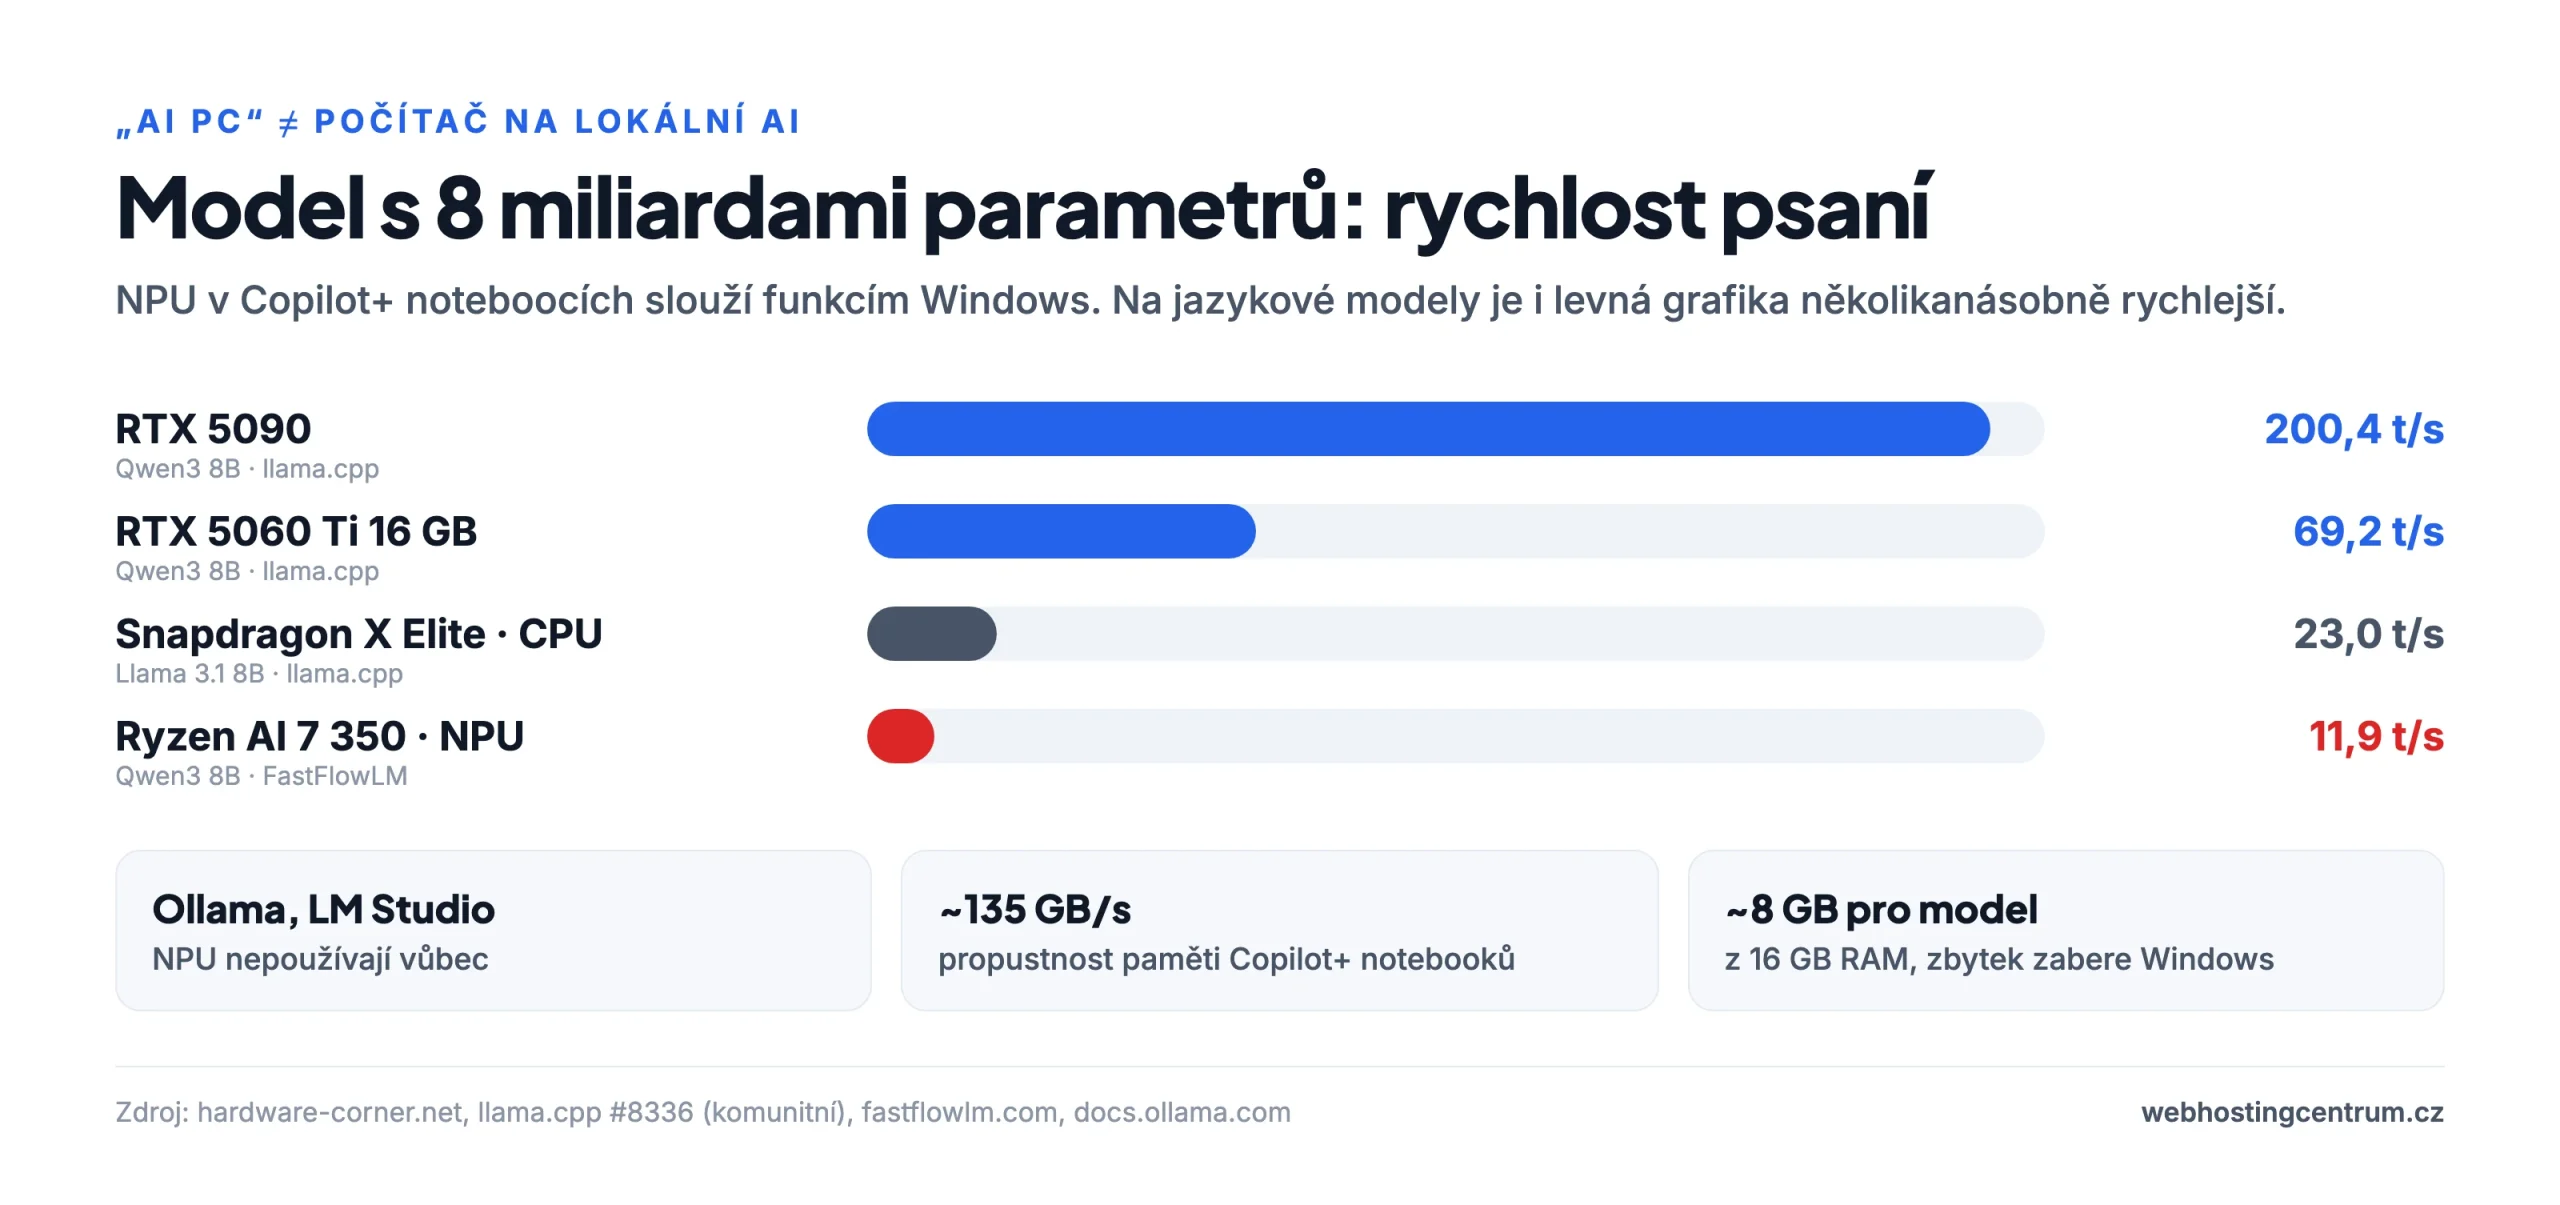
Navíc mají tyto notebooky paměť s propustností kolem 135 GB/s a 16 GB RAM, ze kterých pro model zbude kolem 8 GB. Na modely do 4 miliard parametrů a funkce Windows jsou fajn, na „vlastní ChatGPT doma“ ne.
Pro koho: kancelář, výdrž baterie, malé modely 1–4B. Pro koho ne: kdo chce provozovat modely 14B a větší.
Na Alze: Copilot+ notebooky od 25 166 Kč.
Spotřeba a provoz
Pokud má počítač běžet jako domácí AI server nonstop, záleží i na spotřebě a hluku.
| Zařízení | V klidu | Při běhu modelu / maximum | Poznámka |
|---|---|---|---|
| Mac mini M6 | 4 W | max. 70 W | prakticky neslyšný |
| Mac mini M5 Pro | 6 W | max. 145 W | 5 dBA v klidu (Apple) |
| Mac Studio M5 Max | 7 W | max. 200 W | tichý |
| Mac Studio M5 Ultra | 9 W | ~300 W při AI | podle recenzí tichý |
| DGX Spark | 25–45 W | 60–90 W při AI, špičky do 200 W | podle verze firmwaru |
| Ryzen AI Max+ 395 mini PC | ~13 W | 120–160 W | HP Z2 Mini pod zátěží hlučný |
| RTX 5090 (jen karta) | – | až 575 W | k tomu zbytek PC |
| RTX 5060 Ti (jen karta) | – | až 180 W |
Hodnoty pocházejí od výrobců a z recenzí (ServeTheHome, Tom’s Hardware, Notebookcheck) a nejsou měřené stejnou metodou – berte je jako orientační.
Software: čím model spustit
- Ollama – nejjednodušší start na všech platformách, model stáhnete jedním příkazem. Na Macu od verze 0.19 (zatím v náhledu, pro vybrané modely) používá MLX a neurální akcelerátory M5.
- LM Studio – přehledná aplikace s grafickým rozhraním. Tip pro Mac M5: u modelů GGUF zatím nevyužívá neurální akcelerátory a čte prompt zhruba polovičním tempem; použijte modely ve formátu MLX.
- llama.cpp – základ většiny ostatních nástrojů, nejvíc nastavení a nejrychlejší podpora nového hardwaru. Na Ryzenu AI Max zkuste oba backendy: Vulkan obvykle rychleji píše, ROCm rychleji čte dlouhý prompt.
- MLX – knihovna Applu, nejlepší výkon na Macu včetně propojování více Maců přes Thunderbolt 5.
- vLLM, SGLang, TensorRT-LLM – serverové nástroje pro NVIDIA, když model obsluhuje víc uživatelů najednou.
Nejčastější chyby při nákupu
- Mac s 36 GB „na AI“. Má slabší čip a pro model zbude jen kolem 27 GB.
- RTX Spark notebook s 32 GB. Windows dá grafice nejvýš 16 GB.
- Mac mini M6 s 16 GB. Pomalejší paměť a pro model jen kolem 12 GB.
- Copilot+ notebook kvůli lokální AI. NPU běžné programy nepoužívají.
- RTX 5080 místo 5070 Ti jen kvůli AI. Stejných 16 GB, rychlost téměř stejná.
- Ignorovat propustnost paměti. Velká paměť s pomalou propustností znamená pomalé psaní u hustých modelů.
- Šetřit na paměti. U Maců, Ryzenu AI Max i RTX Spark je paměť napevno a později ji nedokoupíte.
Časté otázky
Stačí na lokální AI 16 GB? Na modely do 14–20 miliard parametrů ano, třeba gpt-oss-20b nebo Qwen3 14B. Na modely kolem 30 miliard potřebujete 24–32 GB, na 70 miliard aspoň 48 GB.
Mac, nebo NVIDIA? Mac rychleji píše a má víc paměti za korunu, NVIDIA rychleji čte prompt a má CUDA. Na chat a agenty s MoE modely vychází lépe Mac, na vývoj, trénink a obsluhu více uživatelů NVIDIA.
Co znamená „MoE“? Mixture of experts: model má hodně parametrů, ale při každém slově počítá jen malou část. Potřebuje velkou paměť, ale píše rychlostí menšího modelu.
Jak rychle musí model psát? Kolem 15 tokenů za sekundu odpovídá rychlosti čtení. Pro plynulý chat je příjemné 30 a víc, pro programovací agenty, které generují hodně textu, se hodí 50 a víc.
Vyplatí se lokální AI proti předplatnému? Finančně většinou ne – modely srovnatelné s nejlepšími cloudovými službami vyžadují stroje za statisíce. Hlavní důvod je soukromí, kontrola nad daty a nezávislost.
Můžu propojit více počítačů? Ano. Dva DGX Sparky se propojí kabelem QSFP, Macy s Thunderboltem 5 přes RDMA (nástroje MLX nebo exo). U Maců mini M6 to kvůli Thunderboltu 4 nejde.
Jak jsme srovnávali a zdroje
Zařízení jsme sami netestovali. Čísla pocházejí z ověřených zdrojů a v grafech je vždy uvádíme. Rychlost porovnáváme v jednom programu (llama.cpp), protože jiný program nebo kvantizace dají výsledky klidně o 20–50 % jiné. Komunitní měření (GitHub, fóra) označujeme. Ceny jsme ověřili na Alze v říjnu 2026.
- Výpadek modelu do RAM, RTX 5060 Ti: inventivehq.com/blog/vram-offload-cliff-gpu-layers-benchmark
- DGX Spark benchmark: github.com/ggml-org/llama.cpp/blob/master/benches/dgx-spark/dgx-spark.md
- Průvodce gpt-oss a měření grafik: github.com/ggml-org/llama.cpp/discussions/15396
- M5 Max a LM Studio: github.com/lmstudio-ai/lmstudio-bug-tracker/issues/2040
- Ryzen AI Max (Strix Halo): strix-halo-toolboxes.com, llm-tracker.info/_TOORG/Strix-Halo
- Apple: apple.com/mac-studio/specs, apple.com/mac-mini/specs, machinelearning.apple.com/research/mlx-distributed-inference
- M5 Ultra: macstories.net/stories/m5-ultra-mac-studio-review-the-dream-mac-for-local-ai-agents
- RTX Spark: theregister.com (16. 10. 2026), servethehome.com, storagereview.com
- Grafické karty GeForce: nvidia.com/en-us/geforce/graphics-cards/compare, hardware-corner.net/gpu-llm-benchmarks
- Žebříčky llama.cpp: github.com/ggml-org/llama.cpp/discussions/15013 a /10879
- Copilot+ PC: microsoft.com/windows/windows-11-specifications, docs.ollama.com/gpu, fastflowlm.com
- Velikosti modelů: huggingface.co (repozitáře ggml-org, unsloth, bartowski)